从 Mac 到单卡 GPU:Qwen2.5-VL 部署、GRPO 与计数 LoRA 实践
这次实验从一个很具体的问题开始:M2 Pro、16 GB 统一内存,能不能在本机跑 Qwen2.5-VL?跑起来之后,我又想把图文问答、推理性能测量和强化学习训练接成一条完整流程。
本机的 MLX 4-bit 服务和云端的 SGLang BF16 服务都能进行图文问答。最初 3 步、随后 30 步 GRPO 都完成了真实参数更新和训练前后评测,但没有观察到可靠的质量提升。后续改用有监督语言 LoRA,并根据独立压力测试补充训练数据,合成计数任务才有了明确改善。
本文最初发布于 2026 年 8 月 19 日,于 2026 年 8 月 21 日补充更新。部署、推理优化和最初 3 步 GRPO 的记录保留,后半部分补充 30 步 GRPO、SFT 扩展、压力测试及两轮定向补训。后续提升不能归因于 GRPO,也不能当成真实照片计数能力的证明。
两个环境,各自解决什么问题
| 环境 | 模型与精度 | 后端 | 本轮用途 |
|---|---|---|---|
| MacBook Pro,M2 Pro,16 GB 统一内存 | Qwen2.5-VL-3B,社区 MLX 4-bit 转换版 | MLX-VLM 0.7.6 | 本地图文问答、批量调用、低并发测量 |
| 云端单卡,设备标称 RTX 4080 SUPER,报告显存约 32 GiB | 原始 Qwen2.5-VL-3B-Instruct,BF16 | SGLang 0.5.5 | CUDA 推理、调参、verl 0.6.1 多模态 GRPO |
云端设备报告了 32760 MiB 显存,这里按实际环境描述,不把它当作标准零售显卡的规格。训练环境固定为 Python 3.12、PyTorch 2.8.0+cu128、Transformers 4.57.1;Mac 的 MLX 环境单独维护。
两边硬件、精度和后端都不同,性能数字用于说明各自的行为。直接拿它们计算“哪个推理框架快几倍”,无法排除这些变量。
本机 4-bit 权重约 3.07 GB,但运行内存还要容纳视觉计算、KV Cache 和临时张量。第一次测试能读出 LOCAL TEST 42,也能识别颜色,却把红色正方形称为矩形。接口返回、页面可用和形状判断正确,需要分别检查。我保留了这条错误,没有为了让验收通过而改判定标准。
一次图文回答怎样走到首个 token
Qwen2.5-VL 的输入链路可以概括为:
图片与问题
  → 图片预处理、视觉编码
  → 视觉 token 与文本 token 组成语言模型输入
  → Prefill:处理输入,建立各层 KV 状态
  → 首个输出 token
  → Decode:复用历史 KV,逐步生成后续 token
Prefill 处理已经知道的输入序列;Decode 则根据历史输入和已生成内容继续预测。每步 Decode 会增加新位置的 K/V,避免重新计算整个历史前缀。图片越大,processor 往往生成越多视觉 token,视觉编码、Prefill 和缓存占用也会随之变化。
实测 processor 对 448×336 图片输出 image_grid_thw=[1,24,32],空间合并系数为 2,因此得到 1×24×32÷2²=192 个视觉 token。加上文本和模板后,主性能实验的输入总长度是 335 tokens。
KV Cache 保存注意力中间状态。普通全注意力、各层结构相同且 KV 未量化时,可作如下估算:
KV bytes ≈ 2 × L × B × T × Hkv × Dhead × bytes_per_element
其中 L 是层数,B 是活跃序列数,T 是每条序列长度,Hkv 是 KV 头数。对本次模型的 36 层、2 个 KV 头、每头 128 维和 2-byte KV,每 token、每序列约占 36 KiB;4096 tokens 约占 144 MiB。这个估算不含权重、视觉激活、临时张量和缓存池空闲空间。GQA 应使用 KV 头数,不能把 16 个 Query 头直接代入;4-bit 权重量化也不代表 KV 自动变成 4-bit。
先把测量口径固定下来
我用流式接口记录首个非空文本片段,同时保留实际输出 token 数和停止原因。几个指标的含义如下:
| 指标 | 本次口径 |
|---|---|
| TTFT,首字延迟 | HTTP 请求发出至首个非空文本 delta,不计只有 role 的片段 |
| 完整响应延迟 | 请求发出至流结束,包含后续 Decode |
| 整组输出吞吐 | 该组成功请求的实际输出 token 总数,除以整组墙钟时间 |
| Mac 内存峰值 | MLX allocator 的进程峰值,十进制 GB |
| GPU 显存采样峰值 | nvidia-smi 每 0.2 秒采样的设备占用最大值,MiB |
TTFT 包含请求提交后的排队、传输、服务端图像处理、视觉编码和语言模型 Prefill;客户端读图、缩放和编码在计时前完成,不能把 TTFT 全部归为纯 Prefill 计算。GPU 性能测量客户端运行在云端机器本机,不包含 Mac 到云端的网络耗时。
max_tokens=128 只规定上限,模型可能提前结束。性能实验要比较相同输出负载:主实验检查实际输出均达到上限,九格调参进一步使用 min_tokens=max_tokens=128。这类回答会被长度限制截断,适合测计算负载;质量评测则允许模型正常结束,保留完整回答。
并发提高了吞吐,也增加了等待
GPU 主实验固定 448×336 图片、335-token 输入、128-token 输出,服务端活跃序列上限为 4,关闭前缀缓存。改变客户端并发后得到:
| 客户端并发 | TTFT p50 | 整组输出吞吐 |
|---|---|---|
| 1 | 67 ms | 97.43 tokens/s |
| 2 | 107 ms | 168.00 tokens/s |
| 4 | 166 ms | 341.41 tokens/s |
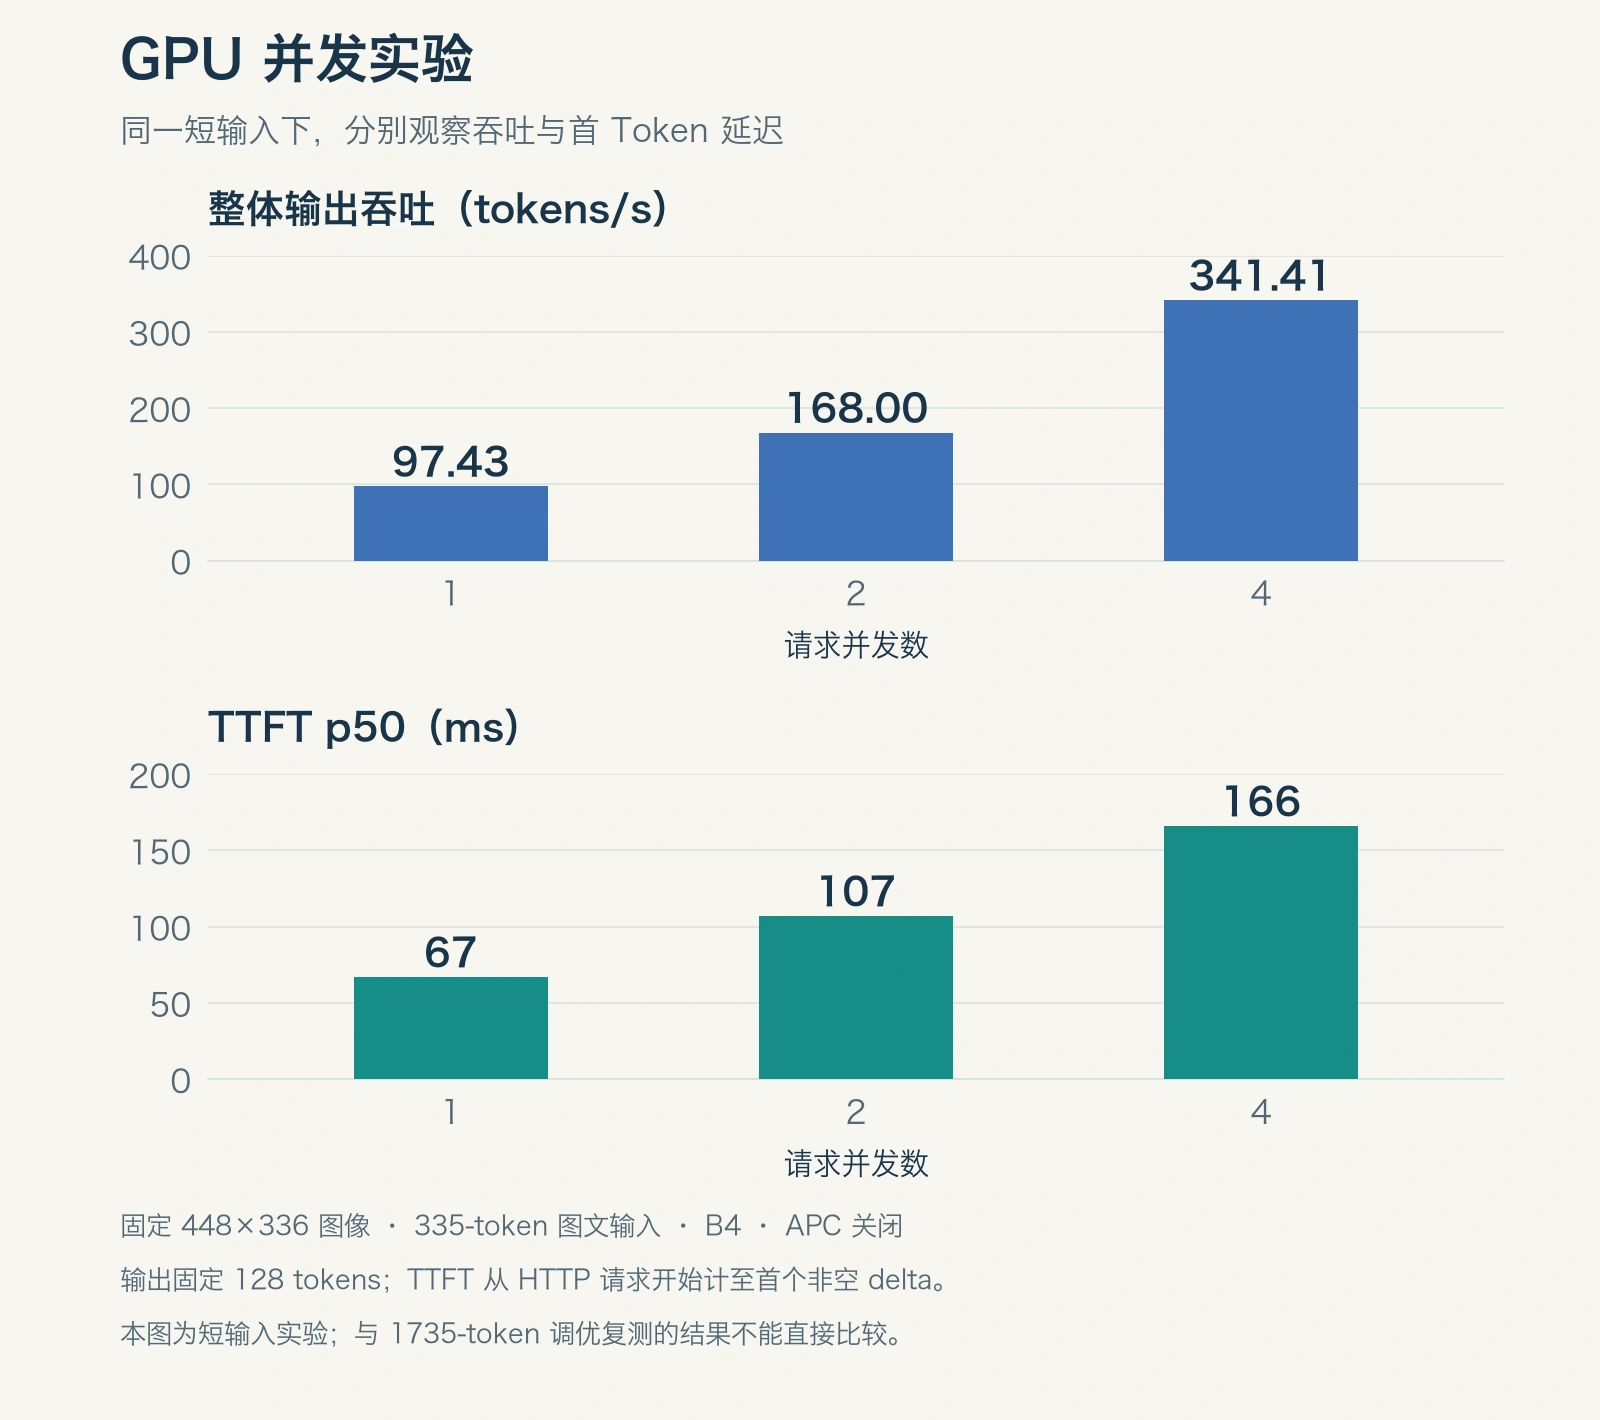
图 1:本轮 GPU 并发实验。主实验七个场景共 48 次测量;并发 4 场景有 12 个请求,其他场景各 6 个,预热不计入统计。查看大图。
Mac 上也观察到同样的取舍:并发 1、2、4 时,吞吐为 57.36、73.80、81.01 tokens/s,TTFT p50 为 0.676、1.183、2.453 秒。交互问答往往更在意等待时间,批量离线任务则可能更在意总吞吐,选参数时需要先确定目标。
客户端并发 C 和服务端活跃批大小 B 是两个设置。为了检查排队的影响,我固定 C=4,只改变 GPU 服务的活跃上限:
| 活跃序列上限 | TTFT p50 | 整组输出吞吐 |
|---|---|---|
| B=1 | 3.931 秒 | 98.44 tokens/s |
| B=4 | 0.166 秒 | 341.41 tokens/s |
这组负载下,B=4 的吞吐约为 B=1 的 3.47 倍。C=4、B=1 时,四个请求并没有同时在 GPU 上推进,后续请求需要排队。连续批处理允许完成的请求退出、等待请求加入,提高活跃槽位的利用率,但它不会保证所有请求都获得相同收益。
分辨率和输出长度也会改变负载。GPU 实验中,图片从 224×168 放大到 896×672,输入长度从 191 增至 911 tokens,TTFT p50 从 53 增至 164 ms;输出上限从 64 增至 256 tokens,完整响应 p50 从 0.681 增至 2.577 秒。同一张图放大不会新增真实细节,这组实验用于观察计算成本。
前缀缓存,需要命中证据
KV Cache 支持当前请求继续 Decode;前缀缓存则复用此前请求相同输入前缀的 KV。SGLang 的 Radix Cache 用树组织可共享的前缀。使用 --disable-radix-cache 关闭前缀复用后,当前请求仍然需要并使用自己的 KV Cache。
我用相同图片和相同的 1741-token 图文前缀,分别测五对冷、暖请求:每对先清理前缀缓存,再发冷请求,随后立即重复输入。
| 配置 | 冷请求 TTFT p50 | 重复请求 TTFT p50 | 重复请求 cached tokens |
|---|---|---|---|
| 前缀缓存开启 | 194 ms | 75 ms | 1740 |
| 前缀缓存关闭 | 177 ms | 177 ms | 0 |
开启组的暖请求明确报告复用了 1740 个 token。关闭组没有同等的延迟下降,因此这里同时有缓存命中和时间差的证据。只看到第二次更快,还可能是编译、内核或其他预热效果。
SGLang 0.5.5 会省略零缓存量的详情字段。探针核对版本、cache-report 和开关状态后,才按该版本语义把这种省略解释为零,并保留原始 usage。
还有一处容易误读:视觉特征缓存复用图像 embedding,与语言模型前缀缓存属于不同层。MLX-VLM 虽然包含通用 VisionFeatureCache,当前 Qwen2.5-VL 路径并不直接读写它。配置一个视觉缓存容量,不能据此宣称重复图片已经命中。
SGLang 九格调参,再独立复测
接下来扫描两个参数:
chunked_prefill_size:256、512、1024。mem_fraction_static:0.55、0.70、0.80。
这一轮固定 1735-token 长图文输入、C4/B4、原始 BF16 模型、前缀缓存关闭和 128-token 实际输出。每组独立重启服务,先运行 4 条预热,再测 12 条请求。首次尝试出现提前 EOS,我单独归档了这些结果,重新固定输出长度后再比较。
筛选规则在执行前写定:排除失败或输出不一致的组合,要求吞吐至少达到基线的 95%,再比较 TTFT p95;p95 接近时优先选较小的显存池。选出的 chunk1024 / mem0.55,还要和基线分别重新启动,各测一组 12 请求:
| 独立复测配置 | TTFT p95 | 整组输出吞吐 | 设备显存采样峰值 |
|---|---|---|---|
| 基线:chunk512 / mem0.70 | 664 ms | 252.27 tokens/s | 23243 MiB |
| 候选:chunk1024 / mem0.55 | 595 ms | 260.34 tokens/s | 18533 MiB |
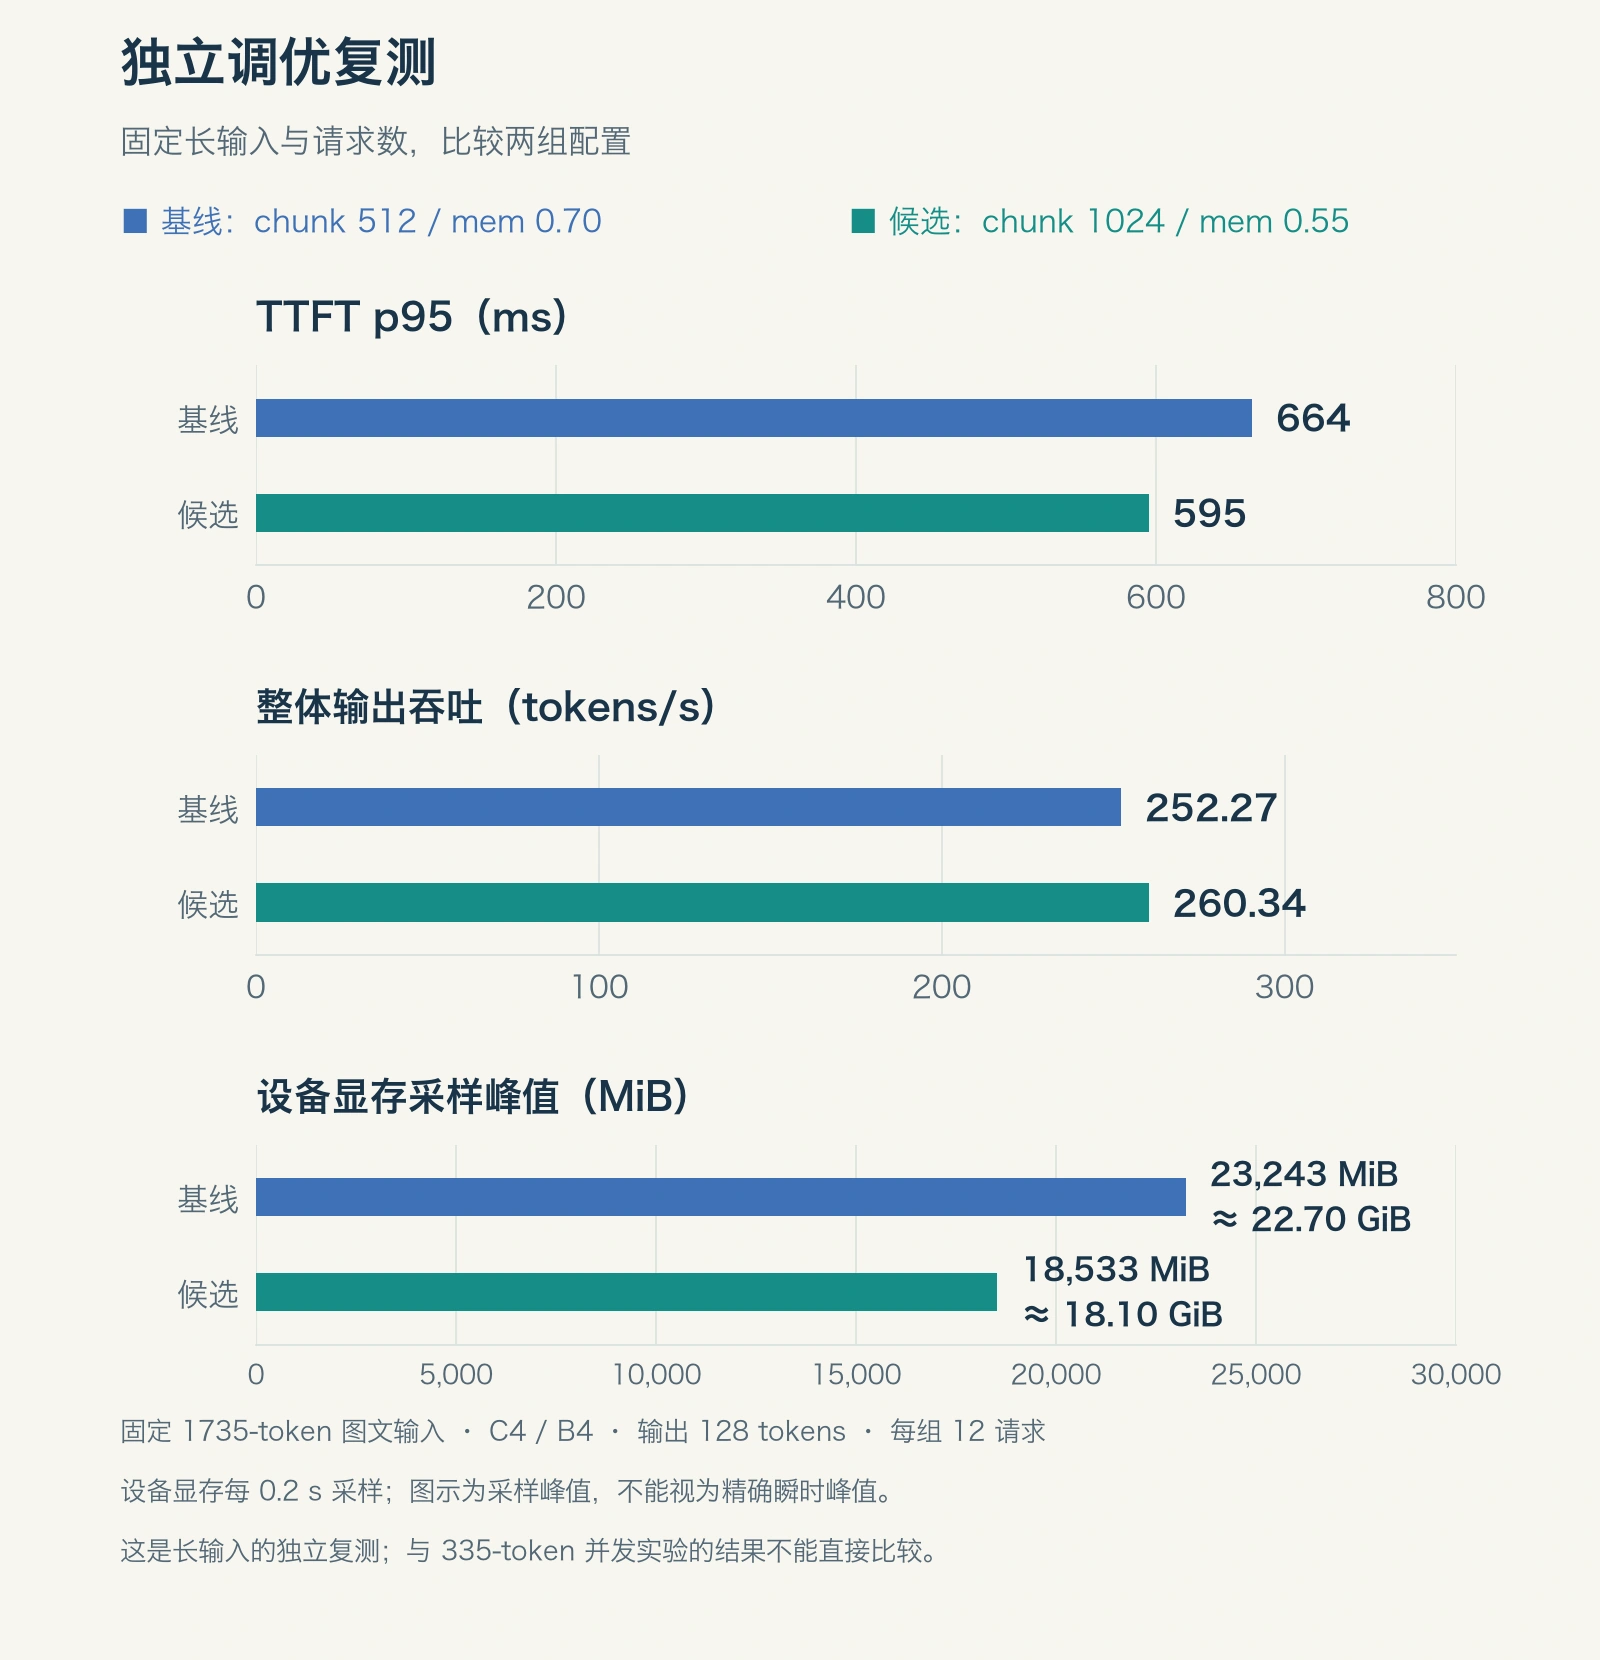
图 2:独立确认数据。候选 TTFT p95 下降约 10.5%,吞吐增加约 3.2%,采样显存峰值减少 4710 MiB,约 4.60 GiB。九格加两组确认共 132 次正式测量,全部成功。查看大图。
显存池缩小后,服务报告的 KV 容量也从 424083 降至 287664 tokens。本轮 C4 负载没有触及容量限制,所以减少闲置池占用更划算;更高并发或更长输入需要重新测量。显存采样包含模型加载、预热和预分配池,可能漏过瞬时峰值;每组只有 12 个请求,p95 也不能当作生产 SLA。
这轮长输入与前面的 335-token 并发实验不同,不能把 260 和 341 tokens/s 当成同一个负载的前后对照。
最终交互服务沿用原始 BF16 模型,使用 TP1、B4、chunk1024、mem0.55,并开启前缀缓存。固定 SGLang 0.5.5 环境准备好后,关键启动参数是:
python -m sglang.launch_server \
  --model-path ./models/Qwen2.5-VL-3B-Instruct \
  --host 127.0.0.1 --port 30000 \
  --dtype bfloat16 --context-length 4096 \
  --tp-size 1 --max-running-requests 4 \
  --chunked-prefill-size 1024 --mem-fraction-static 0.55 \
  --attention-backend triton --mm-attention-backend sdpa \
  --enable-metrics --enable-cache-report
模型路径需要指向原始 HF 权重。本次设备不支持 Hopper 专用的 FA3,语言注意力使用 Triton、视觉注意力使用 SDPA。上述配置对应当前实验,换版本或换硬件后应重新核对可用参数与实际服务配置。
用看图计数跑通多模态 GRPO
我选择了一个能用规则评分的任务:数出图片中的红色圆形和蓝色正方形,按固定 JSON 返回结果。其他颜色和形状作为干扰项。
{"red_circles": 3, "blue_squares": 2}
这只是输出格式示例。训练集包含 128 张合成图,最初留出集为 32 张;图片以 bytes 写入 Parquet,避免依赖本机绝对路径。真值进入奖励字段,不进入图片或提示词。
图 3:原创概念插画,AI 辅助绘制。卡片和旋钮只表达采样与更新,不对应真实回答、奖励值或能力增益。查看大图。
每个图片问题采样 4 个回答,temperature 为 1.0。每步有 4 个不同问题,因此产生 16 条回答。奖励规则很简单:格式合法且两项都对得 1,只对一项得 0.5,格式不合法或两项都错得 0。格式校验还会拒绝重复键、额外字段、布尔值和尾部解释。
GRPO 比较同一个问题的四个回答。固定版本的组内优势可写为:
A_i = (r_i - mean(r_1, ..., r_4)) / (std(r_1, ..., r_4) + 1e-6)
如果一组奖励完全相同,归一化后的优势为零;保存一个 checkpoint 本身不足以证明获得了有效学习信号。我同时检查奖励差异、梯度和权重变化。
训练使用原始 BF16 权重,冻结视觉塔,采用 FSDP2、gradient checkpointing、参数与优化器 CPU offload,学习率为 1e-6,不加载 critic 或 KL reference。总共只跑 3 步,实际采样 12 组图片问题,目标是核验整个流程。
第一次反向传播完成后,AdamW 的 optimizer step 显存不足。将 foreach=False 后,逐个矩阵更新减少了这段临时张量的峰值,训练才完整跑完。CPU offload 也不意味着整个优化器更新都在 CPU 上执行。
| 核验项目 | 实际结果 |
|---|---|
| 参数更新 | 完成 3 步,48 条训练采样 |
| 同问题组内奖励差异 | 12 组中有 9 组 |
| 三步梯度范数 | 2.328125、3.78125、2.5 |
| 完整 HF 导出 | 824 个 tensor 的名称、shape、dtype 与值逐一核对 |
| 语言层变化 | 434 个语言 tensor 中 392 个改变,最大绝对差约 5.72×10^-6 |
| 视觉层冻结 | 390 个视觉 tensor 全部保持原值 |
这些证据说明采样、奖励、反向传播、更新、导出和重新加载都执行了。保存的 checkpoint 只含模型,没有 Adam 状态,适合作为权重产物,但不能保证精确恢复优化器进度。
训练后到底有没有变好
训练程序最初的验证得到了 7/32 全对。后续受控评测的服务与解码条件不同,这个数字不能直接当作前测基线。为了比较效果,我把原始模型和 step3 导出模型分别独立启动,用完全相同的输入和实际服务控制评测。
两份模型都采用 SGLang 0.5.5、BF16、TP1/B1、chunk2048 / mem0.60、seed42、贪心解码和 64-token 输出上限,关闭前缀缓存、overlap 与 CUDA graph,开启 deterministic inference;仅模型路径不同。计数评测包含原 32 张留出图和另外 128 张新图,按文件和 RGB 像素哈希排除与训练集重复。
| 指标 | 原始 BF16 | GRPO step3 |
|---|---|---|
| 160 张计数图两项全对率 | 22/160,13.75% | 22/160,13.75% |
| 160 张计数图平均奖励 | 0.384375 | 0.38125 |
| 计数 JSON 格式合法率 | 100% | 100% |
| TextVQA64,官方方法 soft score | 81.25% | 81.25% |
计数平均奖励差为 -0.003125,配对图片 bootstrap 的 95% 区间是 [-0.015625, 0.00625],包含零。6 张图的计数答案改变,但全对与否的逐图判定全部不变。这里没有观察到提升证据,也不足以确定整体退化。
真实图片从 TextVQA v0.5.1 validation 的固定镜像分片中,按预测前固定的 SHA 排序选取 64 张不同图片,每图一题、10 个人类参考答案。输入只含图片和问题,不传额外 OCR tokens 或参考答案;评分采用固定的官方 MMF EvalAI 规范化和留一标注者 soft score。
两份模型在这 64 题上逐题同分,单模型分数的图片 bootstrap 95% 区间为 [72.1875%, 89.53125%]。这是分片小样本,不能当成官方 5000 题的全量成绩,预训练是否见过图片也未知。配对差区间为 [0,0],仅表示本样本评分差全部为零。
错误复核也很有用:有把 BIG NORM 读成 BIG NORTH 的 OCR 错误,也有目标选择失配。还有回答包含正确文字、但答案范围不符合参考的情况;例如单位 200ml 和 200 ml 在固定评分规则下并不相同。我保留完整回答,不在看到结果后改评分规则。
计数前后共 320 个请求,真实图片前后共 128 个请求,448 个评测请求全部成功。HTTP 成功率和任务得分分别统计,能避免把“没有报错”写成“模型答对了”。
后续 30 步 GRPO:更新了参数,仍未观察到可靠提升
从固定的原始 BF16 权重和全新 AdamW 状态重新开始,完成 30 个优化步。120 张不同训练图各采样 4 条回答,共 480 条;梯度非零,导出权重也确实发生改变。迁移到新机器后核对权重哈希,重新完成两个模型各 352 张、共 704 次推理,不混用迁移前后的不完整结果。
新增、训练前冻结的 128 张留出图上,两项计数都正确的图片从 22 张变成 23 张,但平均奖励从 0.4453125 降至 0.44140625,奖励差的配对 bootstrap 95% 区间为 [-0.0234375, 0.015625],包含零。重复 TextVQA64 的 soft score 仍为 81.25% → 81.25%。
这次实验说明训练链路和参数更新有效,不说明任务质量改善。后来的 SFT 使用不同训练方法、数据量和推理口径,不能把其结果写成“30 步 GRPO 带来的提升”。
换成有监督 LoRA:先建立能改善的基线
小规模试训观察到改善后,扩展到 768 张新训练图,覆盖红圆、蓝方各 0–7 的组合和渲染变体。冻结视觉与基座参数,仅训练语言侧 LoRA,rank 为 8、alpha 为 16;基座和计算使用 BF16,训练参数与优化器状态使用 FP32。
学习率为 2e-4,共 6 轮、1152 个优化步。96 张独立开发图在第 2、4、6 轮候选中选出第 4 轮,最终测试不参与选权。所有比较都采用同一 Transformers 后端和 448×448 图像处理。
| 独立合成测试 | 原始基座 | 开发集选出的 LoRA |
|---|---|---|
| 原渲染器新图 128 张,两项计数都正确 | 19/128,14.84% | 118/128,92.19% |
| 渲染变体新图 128 张,两项计数都正确 | 17/128,13.28% | 113/128,88.28% |
| 重复 TextVQA64,soft score | 70.00% | 70.625% |
前两组奖励增量的配对 95% 区间分别为 [0.476562, 0.597656] 和 [0.519531, 0.660156],均高于零。1056 次生成完成,7 项预先冻结的验收条件通过。
这里的 TextVQA 70% 与前文 SGLang 的 81.25% 不是同一推理和图像处理口径,不能拼成一条训练前后曲线。 TextVQA64 也只是重复使用的回归保护集,不是新增的完整基准测试。
压力测试暴露了什么
固定上述适配器,不再训练,另生成四组各 64 张新图,比较原始基座和适配器,共 512 次推理。结果没有同分布测试那么整齐:
| 压力场景 | 原始基座全对数 | SFT 适配器全对数 |
|---|---|---|
| 散布排列 | 6/64 | 56/64 |
| 密集小物体 | 0/64 | 48/64 |
| 空心形状 | 7/64 | 31/64 |
| 数量 8–12 | 2/64 | 1/64 |
对象都可见且不重叠,但空心形状明显更难;训练仅覆盖 0–7 时,8–12 没有改善。高数量样本中经常回答 7,这与训练范围有关是一个合理假设,却不是因果证明。不能凭常规图的 92.19% 就推断模型已经学会普适计数。
两轮定向补训:第一次没达标,第二次才通过
第一轮从扩展 SFT 的第 4 轮适配器继续训练。新增 1014 张图,覆盖两个计数各 0–12 的 169 种组合,并回放 266 张旧训练图,总计 1280 张。学习率 1e-4,训练 6 轮、1920 步,192 张独立开发图选择第 4 轮。
这一轮有改善,但散布排列全对率仅 76.56%、空心 73.44%、8–12 为 53.125%,共 4 项冻结条件未通过。候选、日志和失败结果全部保留,没有降低阈值,也没有用最终测试去挑第 6 轮权重。
第二轮从第一轮开发集选出的适配器继续训练,新增 1280 张图:676 张均衡散布图、400 张高数量组合图和 204 张空心图;再回放第一轮全部 1280 张训练图。学习率降至 5e-5,训练 3 轮、1920 步,独立开发集从第 1、2、3 轮选择第 2 轮。
两个补训轮次使用各自新生成的开发与最终测试图。旧压力测试和第一轮最终测试图没有加入第二轮训练。下表两列都来自第二轮同一批新测试图:before 是第一轮适配器,不是原始基座。 不同轮次测试图和数量范围有变化,不能横向拼接各轮分数。
| 第二轮独立测试,每组 64 张 | 第一轮适配器 | 最终适配器 | 部分奖励增量的 95% 配对区间 |
|---|---|---|---|
| 常规排列,0–7 | 63/64,98.44% | 63/64,98.44% | [-0.0234, 0.0234] |
| 渲染变体,0–7 | 64/64,100.00% | 64/64,100.00% | [0.0000, 0.0000] |
| 散布排列,0–12 | 52/64,81.25% | 58/64,90.625% | [-0.0078, 0.1016] |
| 密集小物体,0–12 | 51/64,79.69% | 60/64,93.75% | [0.0312, 0.1641] |
| 空心形状,0–12 | 40/64,62.50% | 55/64,85.94% | [0.0625, 0.2031] |
| 数量 8–12 | 32/64,50.00% | 55/64,85.94% | [0.1094, 0.2500] |
“全对”要求红圆与蓝方两个数量同时正确;部分奖励是两个字段正确率的均值。表中的区间对应部分奖励差,不是全对率差。散布组分数上升,但奖励区间仍包含零,不能声称这组已证明统计显著改善。
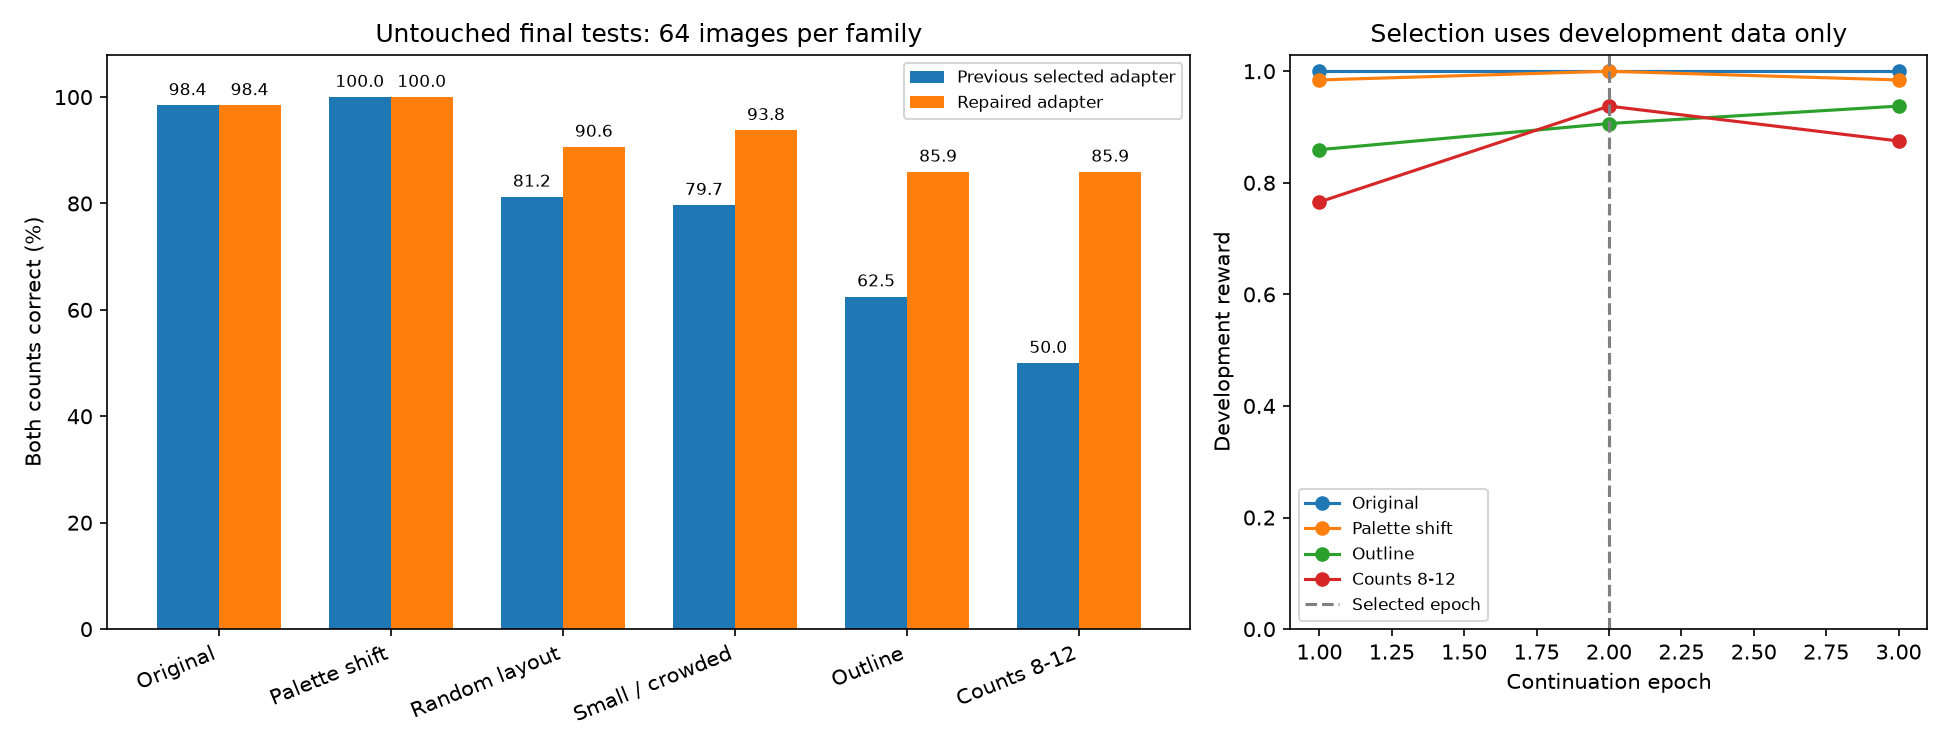
验收规则没有事后修改
第二轮沿用第一轮预先冻结的 15 项条件:常规、渲染变体、散布、密集、空心、8–12 的全对率下限依次为 85%、80%、80%、70%、75%、60%;空心和 8–12 的部分奖励至少 0.8,且奖励差区间下界高于零;其余四组部分奖励及 TextVQA 的下降不能超过 5 个百分点。
最终 15 项全部通过。重复 TextVQA64 的同口径 soft score 从 70.625% 变为 70.15625%,下降 0.46875 个百分点,在预先设定的容许范围内。通过回归门槛不等于完全没有退化,更不等于通用能力提升。
第二轮共完成 1600 次生成:训练图诊断、独立最终测试的前后比较,以及三个候选的开发集评分;其中最终比较每个模型包含 384 张合成图和 64 张 TextVQA 图。训练与评测约 83.3 分钟。两轮补训合计执行 3840 个优化步、3200 次评测生成。
参数、数据和调用路径都做了复核
独立审计复算图片哈希与数据隔离、场景标签、对象可见性和非重叠、训练覆盖、梯度与监督掩码、实际 FP32 权重变化、开发集选权规则,以及最终适配器是否与选中候选一致。配对评测的输入张量哈希也逐图核对。
相关 CPU 测试 54 项通过,历史证据复核 8 个部分通过。另用独立命令实际加载最终适配器,测试一张 11 个红圆、12 个蓝方的图,返回:
{"blue_squares": 12, "red_circles": 11}
回答、生成 token IDs 和输入张量哈希与原评测一致。这张图已用于评测,所以只算调用一致性验证,不算新增独立成绩。
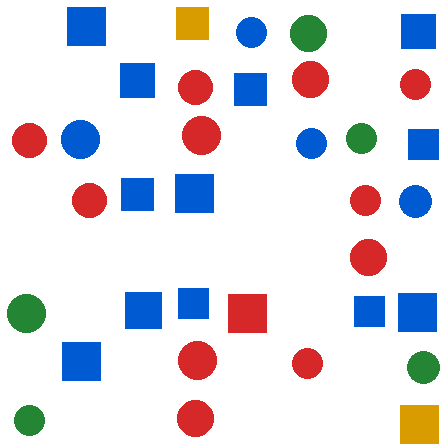
最终产物是约 57.2 MiB 的语言 LoRA,保存在实验项目的 verl_lab/outputs/counting-repair-v2/selected/adapter/,没有导出完整合并模型。原始证据保留在同级目录的 plan.json、before.jsonl、after.jsonl、training.jsonl、dev-epoch*.jsonl、audit.json 和 completion.json。这些是本地实验路径,不是公开下载地址。
目前能说什么,不能说什么
- 可以说:固定测试协议下,合成、可见、无重叠几何形状的计数有改善,最终达到预设操作性门槛。
- 不能说:GRPO 已有效提升;有明确改善的是后续有监督 LoRA。
- 不能说:8–12 是最终模型的数值外推。补训已经覆盖 0–12,内部数据分组名虽沿用
extrapolate,实际是训练范围内的新图片泛化。 - 不能说:真实照片、遮挡、重叠或超过 12 的数量已经验证。TextVQA 回归集不能替代真实照片计数评测。
- 不能说:单次训练结果证明稳定收益。只有一个训练随机种子,bootstrap 重采样的是配对图片,不是多次训练运行。
新的 LoRA 已可通过独立命令调用,但未替换原网页默认模型,也不能直接用于旧 Mac 4-bit MLX 模型。实验结束后释放了 GPU 显存与训练锁;云实例没有关机,释放显存不等于停止计费。
下一步应先补真实照片计数评测,再测重叠、遮挡、超过 12 的数量,并扩大独立样本、做多训练种子复现,而不是继续刷同一类合成图。
这轮实验留下的做法
现在回看,最有用的记录并不是单独一个 token/s,而是能说明这个数字怎样得到的条件:模型与精度、输入长度、实际输出长度、并发与活跃上限、缓存状态、预热和计时范围。
读源码时,我沿着 SGLang 的 get_next_batch_to_run()、get_new_batch_prefill()、update_running_batch() 看请求怎样进入和退出批次,再沿着 Radix Cache 的 match_prefix()、insert()、evict() 看状态怎样复用。这样能把 C4/B1 的排队和缓存冷暖差异对应到实际实现。
本轮只使用单卡,TP=2 没有实测。M2 Pro 的 19 个 GPU 核心属于一个设备,也不等于 19 张卡。要研究张量并行的收益,需要多设备和通信测量。
后续补训印证了按失败类型补数据的价值,也暴露了同分布高分的局限。训练流程跑通、权重发生变化、特定测试达到门槛和真实场景可用,是四件不同的事。原 3 步和 30 步 GRPO 的无可靠提升结果,与后续 SFT 的合成计数改善,应当一起保留。
参考资料与固定版本
- Qwen2.5-VL 官方介绍与本次原始 3B 模型 revision。
- MLX-VLM 固定 commit与MLX 4-bit 模型 revision。
- SGLang 0.5.5 固定 commit:调度器、Radix Cache、启动参数。
- verl 0.6.1 固定 commit:官方多模态 GRPO 示例、数据集实现。官方示例使用 7B;本文实际实验使用 3B 和上述单卡配置。
- TextVQA 官方数据与任务说明及MMF TextVQA 评分实现。
封面与正文概念插画由 AI 辅助生成;性能图和新增计数结果图按实测数据绘制,调用示例使用实际测试图和输出。