在 M2 Pro 上完成 Qwen3 两阶段训练:Mid Train、SFT 与可复核评估
在一台 M2 Pro、16 GB 内存的 Mac 上,能否把一个 Base 语言模型接续训练成输出 JSON 的运维事件分级助手?这次项目完成了领域持续训练、监督微调、检查点选择、重新加载和独立测试,并保留了权重、日志和数据哈希。
最终验证集分级正确 14/15,测试集 15/15,两个集合的严格 JSON 合法率都是 15/15。这里的样本是可复现的中文合成事件,测试集也只有 15 条。这组结果适合检验训练流程,不能作为真实运维场景的准确率。
本文记录 2026 年 9 月 30 日完成的这轮实验,重点解释三个问题:两个训练阶段怎样接续;为什么最初的 Base 模型会输出重复符号;怎样让训练、评估和实际推理使用同一套监督边界。
训练了什么
项目从 mlx-community/Qwen3-0.6B-Base-4bit 开始。它是社区转换的 MLX 量化版本,原始模型为 Qwen 官方的 Qwen3-0.6B-Base。官方模型卡标明它处于预训练阶段、包含 28 层;MLX 模型卡记录了转换来源。[1][2]
本次实际使用的量化模型 revision 为:
f493c65c2f0ff5a5fe37cc435cf8e2f1b6e72cf7
本文把项目中的两个阶段称为:
| 阶段 | 本项目的具体含义 | 数据 | 监督目标 |
|---|---|---|---|
| Mid train | 在已有 Base 模型上继续学习领域文本 | 运维描述、影响范围和处置说明 | 文本的下一个 token 与原生 EOS |
| Post train | 对目标任务做监督微调,即 SFT | 系统指令、事件描述、assistant 回复 | 最后一条 assistant 回复与原生 EOS |
两阶段都冻结 4-bit 基座,训练全部 28 层中的 LoRA 参数,约 505 万个可训练参数。MLX-LM 支持在量化模型上进行 LoRA 训练,也支持从已有适配器继续训练。[3]
这里的“完整训练”指按配置完成两阶段全部步数并验证交付产物。没有从零训练 0.6B 模型的全部参数,也没有加入 DPO、RLHF 或奖励模型。
任务只要求回答一个字段:
{"severity":"P1"}
分级规则在系统指令中明确给出:P0 为核心业务全局不可用,P1 为局部、单区域或非核心功能受损,P2 为单用户问题或操作咨询。因此,这也是一个带有显式规则的任务,不能把结果解释为模型自行掌握了所有业务分级标准。
先划分事件来源,再生成两阶段数据
训练数据规模如下:
| 数据 | Train | Validation | Test |
|---|---|---|---|
| Mid 领域文本 | 90 | 15 | 15 |
| SFT 对话 | 180 | 15 | 15 |
三个级别在每个集合中均衡分布。训练集使用 18 个场景族,每个场景族生成 5 个独立事件;每个事件对应 1 条 mid 文本和 2 条 SFT 表达。验证集和测试集各使用另外 15 个场景族,每族 1 个事件。生成器会先把场景族分到集合,再渲染文本。
这一步约束要同时覆盖两阶段:如果同一事件的 mid 文本进入训练集,而 SFT 问答进入测试集,测试仍可能泄漏。项目通过 source_id 保证同一事件在 mid 和 SFT 中只属于同一个 split,并检查重复内容、唯一 ID 和场景族交叉。
JSONL 的结构很简单。下面只展示字段格式,属于示意样本:
{"id":"mid-example-01","source_id":"example-01","text":"下单接口在所有区域连续返回 HTTP 503。"}
{"id":"sft-example-01","source_id":"example-01","messages":[{"role":"system","content":"只输出事件级别 JSON。"},{"role":"user","content":"所有区域都无法下单,级别是什么?"},{"role":"assistant","content":"{\"severity\":\"P0\"}"}]}
长度检查使用真实 tokenizer,超过上下文上限的样本会报错,避免截断掉 SFT 的目标回复。当前配置上限是 384 token。
来源隔离可以排除同一事件和其改写跨集合的问题,但各集合仍由同一套合成生成器构造,表达风格和任务规则相似。真实泛化需要另外采集人工标注、自然表达的事件。
第一个问题:Base 模型的聊天标记无法区分
初始尝试沿用了聊天模板。模型生成重复标点,完整回复无法解析成 JSON。增加训练步数之前,先检查了模板中的特殊 token。
对本次量化快照的词向量直接测量,得到:
| Token | Token ID |
|---|---|
<|im_start|> |
151644 |
<|im_end|> |
151645 |
<think> |
151667 |
</think> |
151668 |
四个向量的最大两两绝对差为 0。该快照还使用 tied word embeddings,即输入词向量与输出词表投影共享权重。
在这一具体设置下,冻结的相同向量无法表达这几个 token 身份之间的差别;相同输出行也使它们在同一个上下文中得到相同的 logit。只修改中间层 LoRA,无法让结束标记的输出概率独立于另一个相同向量的标记提高。
这是一项针对固定快照的测量,不能推广成“所有 Qwen 模型的特殊 token 都相同”。测量记录已保存为 runs/reports/base-chat-token-probe.json。
本次采用普通文本角色标签,并使用 Base 模型的原生 <|endoftext|> 结束符:
系统:
你是运维事件分级助手……只输出包含 severity 字段的 JSON。

用户:
只有华东一区支付回调失败,其他区域正常。请给出事件级别。

助手:
{"severity":"P1"}<|endoftext|>
编码逻辑集中在 midpost/formatting.py。训练和评分使用 encode_record,推理使用同一模块的 encode_prompt,从而保持 assistant 回复之前的 token 前缀一致。
还有一点容易忽略:提示词与回复分别编码后拼接,推理也必须使用同样的前缀编码方式。仅仅让字符串看起来相同,不足以证明边界上的 token 一致。
第二个问题:Loss 把首个 padding token 算了进去
SFT 只对 assistant 的最后一条回复计算交叉熵。系统指令、用户输入和 padding 都不应进入分母。
设原始序列长度为 L,assistant 回复的起点为 offset。因果语言模型把输入右移一位形成目标后,目标对应的原序列位置从 1 开始。有效位置必须满足:
offset <= target_position < L
边界应使用严格小于 L。序列最后一个有效位置是 L - 1,位置 L 已经属于 padding。
本项目修正了沿用的损失边界,核心实现如下:
targets = batch[:, 1:]
logits = model(batch[:, :-1]).astype(mx.float32)
positions = mx.arange(1, targets.shape[1] + 1)
mask = (positions >= lengths[:, 0:1]) & (positions < lengths[:, 1:])
token_count = mask.sum()
losses = nn.losses.cross_entropy(logits, targets)
loss = mx.where(mask, losses, 0.0).sum() / token_count
Mid 的 offset 为 0,因此监督实际存在的 next-token 目标;SFT 的 offset 指向回复开始位置。两者都包含原生 EOS,且都排除 padding。
评估采用相同函数,并按监督 token 数加权。这样,训练 loss、验证 loss 与测试 loss 才是在同一套边界下计算的。
第三个问题:长跑出现 NaN,稳定后仍需调学习率
早期 bfloat16、恒定学习率的试验在后期出现非有限 loss。最终训练做了以下调整:
- 可计算参数和激活采用 float32,基座量化权重仍保持 4-bit。
- Adam 的 epsilon 设为
1e-6。 - 全局梯度范数上限设为 1。
- 学习率按余弦曲线衰减,末值为初值的 10%。
- 训练报告和验证报告中的非有限 loss 会触发异常。
- 交付前检查选出适配器的全部张量是否为有限值。
组合调整后,最终两阶段日志中的训练和验证 loss 均为有限值。这轮实验没有逐项消融,不能把改善归因于其中某个设置。
数值稳定也不等于任务已经学好。第一次稳定的 float32 SFT 使用 1e-4 初始学习率,验证集只正确 8/15,仍存在 P2 被判断为 P1 的问题。根据验证集表现,把初始学习率降到 3e-5 后完成最终训练。测试集在最终配置和检查点固定后才用于交付评估。
两阶段怎样接续
最终运行配置为:
| 参数 | Mid | SFT |
|---|---|---|
| 初始学习率 | 8e-5 |
3e-5 |
| Microsteps | 360 | 2,160 |
| 梯度累积 | 4 | 4 |
| 优化器更新次数 | 90 | 540 |
| Batch size | 1 | 1 |
| 训练数据遍数 | 4 | 12 |
| 上下文上限 | 384 | 384 |
| LoRA 层数 | 28 | 28 |
| LoRA rank / scale | 8 / 20 | 8 / 20 |
| LoRA dropout | 0 | 0 |
| 随机种子 | 42 | 42 |
iters 在这里统计微步。Batch 为 1、累积为 4,所以 360 微步对应 90 次优化器更新。为了减少解释歧义,训练元数据同时记录两种步数和近似 epoch 数。
SFT 加载 mid 选出的 LoRA 权重,继续更新同一套适配器参数;它会重新初始化优化器和计步器。两个阶段写入不同目录,便于分别评估,也避免覆盖 mid 权重。
接续关系通过哈希核验:SFT 元数据中的 resume_sha256 必须与 mid 交付权重的 SHA-256 一致。最终记录为:
mid f6f1698b16e55617c145f5ca7a3a3a2d8b3ac01aa0bbb25c5554873a0bf55c2e
sft bf53c7aaa1ddd6015e70df944c2d62d4ed7f007e7347389bc9f09d179f69aabf
最终 mid 训练耗时约 53.4 秒,SFT 约 361.7 秒。它们只包含这两个最终运行阶段的计时,不包含下载、排查、历史试验和最终测试,也不能外推成其他数据规模的训练速度。
跑满步数以后,交付验证集选出的权重
两阶段都完成了全部配置步数,但默认推理使用验证 loss 最低的检查点。
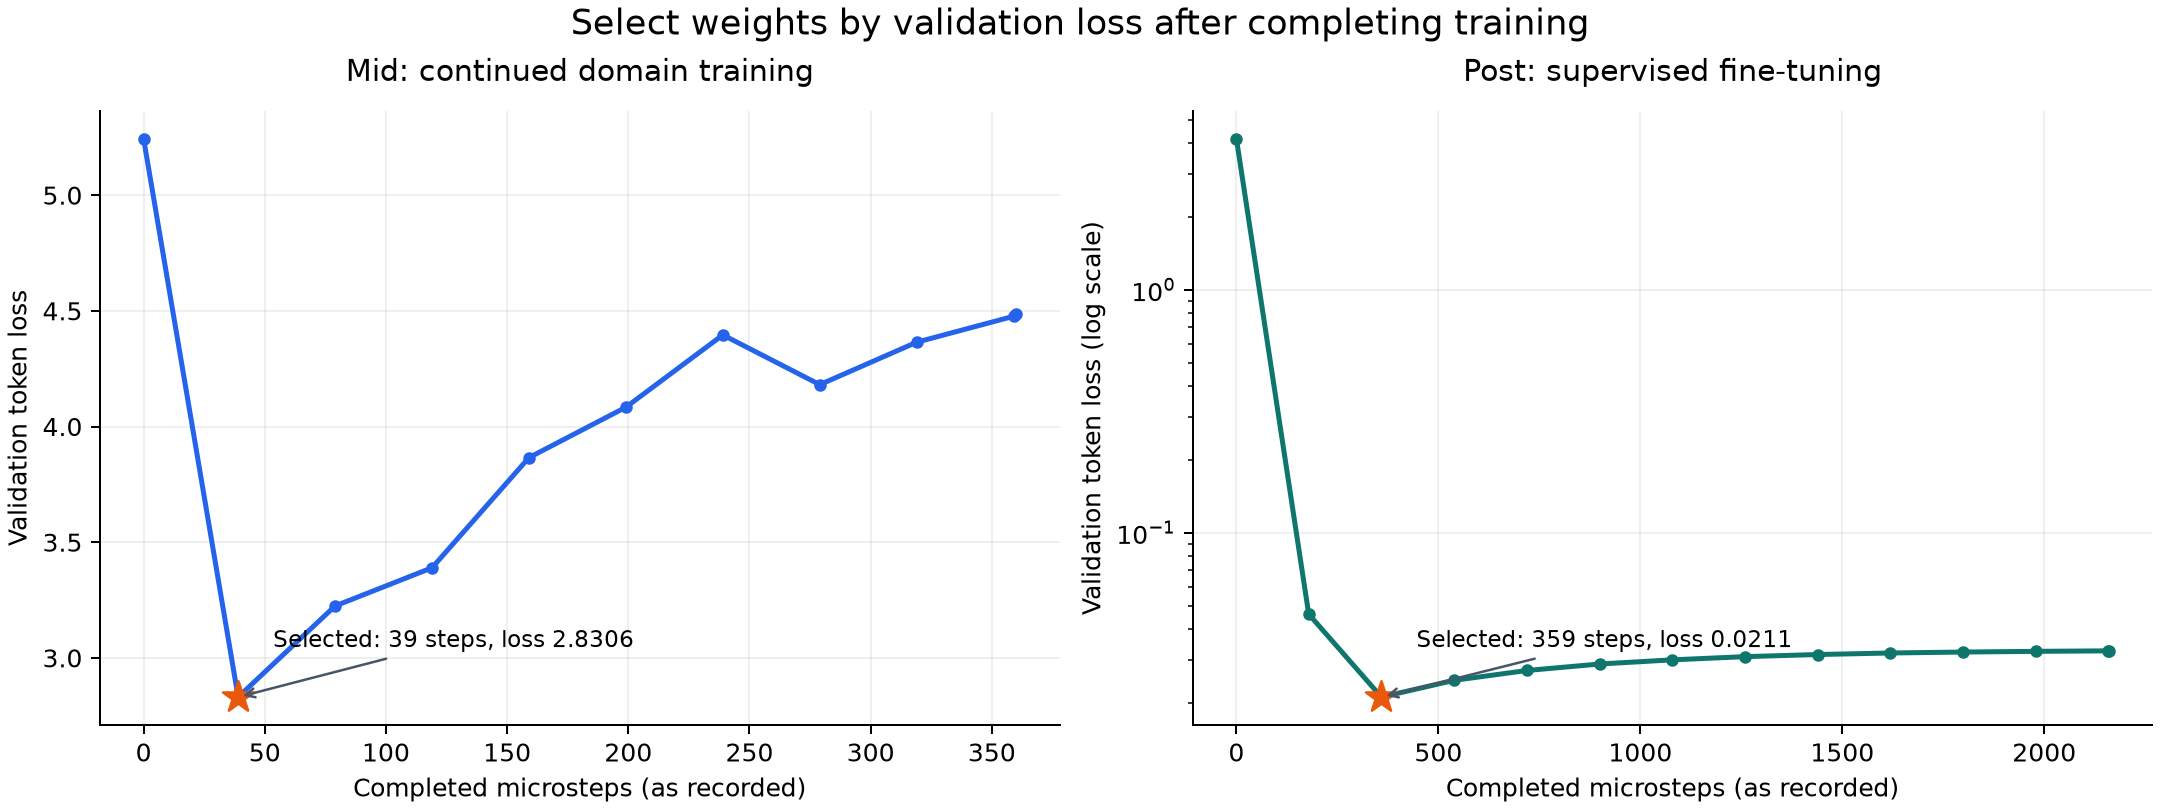
本文原创:用 Matplotlib 根据两个阶段的 metrics.jsonl 和 selection.json 绘制。横轴为记录的已完成微步,右图纵轴采用对数刻度;星号标出选中的权重。绘图代码为项目中的 tools/plot_training.py。
Mid 的最佳验证 loss 约为 2.8306,最后权重约为 4.4858;SFT 的最佳验证 loss 约为 0.02108,最后约为 0.03268。继续训练以后,验证 loss 已经回升。
记录中的最佳检查点分别完成 39 和 359 个微步。它们是回调发生时已完成的微步数;当时尚未执行下一次更新,因此沿用训练器日志的编号会容易产生差一的问题。项目对此有单独测试。
保存关系为:
| 文件 | 含义 |
|---|---|
best.safetensors |
验证 token loss 最低的权重 |
last.safetensors |
全部配置步数跑完后的权重 |
adapters.safetensors |
最佳权重的副本,供默认推理加载 |
selection.json |
选择集合、步数、loss 和权重哈希 |
这次选择只使用验证集。测试集不参与保存最佳检查点或调整最终学习率。
测试了什么,结果怎样读
最终评估同时检查语言建模损失和生成行为。
| 指标 | 结果 |
|---|---|
| 验证集分级正确 | 14/15,93.3% |
| 验证集严格 JSON 合法 | 15/15 |
| 测试集分级正确 | 15/15,100% |
| 测试集严格 JSON 合法 | 15/15 |
| 测试集 P0 / P1 / P2 正确 | 各 5/5 |
| Base 领域测试 loss / perplexity | 5.17717 / 177.1814 |
| Mid 领域测试 loss / perplexity | 2.95622 / 19.2251 |
| SFT 回复测试 loss / perplexity | 0.00004552 / 1.00004552 |
领域测试共有 778 个监督 token,用同一数据和损失函数比较 Base 与 mid。SFT 回复测试共有 105 个监督 token,只统计最终回复及 EOS。二者的目标不同,不能直接比较 loss 大小来判断哪个阶段更强。
SFT 回复很短,输出空间也只围绕三个级别。接近 1 的 perplexity 表示在这些目标回复上的预测很确定,不能说明通用语言建模、复杂推理或长文本能力。
生成评分采用贪心解码,完整回复必须可以直接被 json.loads 解析,且只能有一个 severity 字段,其值必须是 P0、P1 或 P2。评分不通过截取 JSON、修补输出或替换预测来提高结果。
实际重新加载后运行:
python -m midpost infer '只有华东一区支付回调失败,其他区域正常。请给出事件级别。'
得到:
{"severity":"P1"}
目前没有完成“直接 SFT”与“mid 后 SFT”的控制实验。领域 perplexity 降低支持模型对这批文本产生了适应,但无法据此证明 mid 阶段提高了最终分类准确率。下一轮应补上这一对照,并扩大真实独立测试集。
复现和交付内容
项目保存在 GitHub 私密仓库,访问与克隆需要权限。公开文章用于说明实现与结果,仓库保留代码、合成数据、配置和可直接加载的适配器。
本次环境版本为 Python 3.11.15、MLX 0.32.0、MLX-LM 0.31.3、Transformers 5.12.1,核心依赖固定在 requirements-repro.txt。模型 revision 和数据哈希保存在报告中;如果模型仓库以后变化,复现应使用本文记录的快照。
在具有仓库权限的 Apple Silicon 环境中:
git clone https://github.com/liangqianxing/mid-post-train.git
cd mid-post-train
python3.11 -m venv .venv
.venv/bin/python -m pip install -r requirements-repro.txt -e .
.venv/bin/python -m midpost validate --tokens
.venv/bin/python -m midpost infer '只有华东一区支付回调失败,其他区域正常。请给出事件级别。'
.venv/bin/python -m midpost score
首次运行需要下载基座,GitHub 仓库只保存适配器。重新训练需要为两个阶段指定新的输出目录,已有目录会拒绝覆盖。例如:
cp config-complete.toml config-retrain.toml
把新配置的两个 adapter 分别改成 runs/retrain-mid 和 runs/retrain-sft,然后运行:
.venv/bin/python -m midpost --config config-retrain.toml train all
主要证据文件如下:
| 内容 | 项目路径 |
|---|---|
| 两阶段完整说明 | TRAINING_REPORT.md |
| Mid 权重与训练元数据 | runs/complete-fp32-mid/ |
| SFT 权重与验证预测 | runs/complete-calibrated-sft/ |
| 最终完整测试预测与混淆矩阵 | runs/reports/test-score.json |
| Base 与 mid 领域测试对照 | runs/reports/base-mid-test-loss.json、mid-test-loss.json |
| SFT 回复损失 | runs/reports/sft-test-loss.json |
| 特殊 token 词向量测量 | runs/reports/base-chat-token-probe.json |
| 环境、源码哈希与评估汇总 | runs/reports/training-summary.json |
仓库包含两阶段的选出权重、最佳权重副本、最后一步权重、日志和元数据。编号检查点与历史失败试验仅保留在原训练机器上,避免让交付目录混入旧模型。
18 项单元测试覆盖了提示词和 padding 掩码、训练与推理前缀、原生 EOS、来源与场景族隔离、检查点步数和非有限 loss 拒绝。它们验证实现边界;真实业务效果仍需要新的数据来检验。
这轮项目得到的可复用部分,是一条能够核验来源划分、监督 token、两阶段权重接续和交付选择的训练流程。下一步最有价值的工作,是引入真实工单、做直接 SFT 对照,并观察模糊描述、多个故障同时出现和规则变更时的行为。
一手参考资料
- Qwen 官方 Qwen3-0.6B-Base 模型卡:模型来源、预训练阶段与 28 层结构。
- 本次使用的 MLX 量化模型卡:转换来源与固定快照。
- MLX-LM 0.31.3 的 LoRA 文档:量化模型微调、适配器接续和 prompt masking。
本文的训练耗时、词向量测量、检查点哈希和评估结果均来自项目实际产物;参考资料用于核验模型与框架信息。