从零实现 Transformer:用 NumPy 理解注意力、梯度与训练
项目代码:liangqianxing/lm-lab。
上一篇 BPE 分词器文章解决了“文本如何变成 token ID”。这一篇继续往下走:把 token ID 输入模型,得到下一个 token 的预测,再沿计算图反向传播。项目的模块划分和后续工作放在项目总结中,这里集中解释模型核心。
本文讨论的是用于自回归语言建模的 decoder-only Transformer,以 NumPy 展示张量运算。代码是教学节选,不包含每个类的初始化、全部缓存和 dropout 分支;训练循环另行标注为流程骨架。源码核对版本为 bf854b1。该版本也包含 PyTorch 训练工具;NumPy 模型核心与训练接口仍需分别验证,本文不声称端到端训练已通过。
先把数据流和形状写清楚
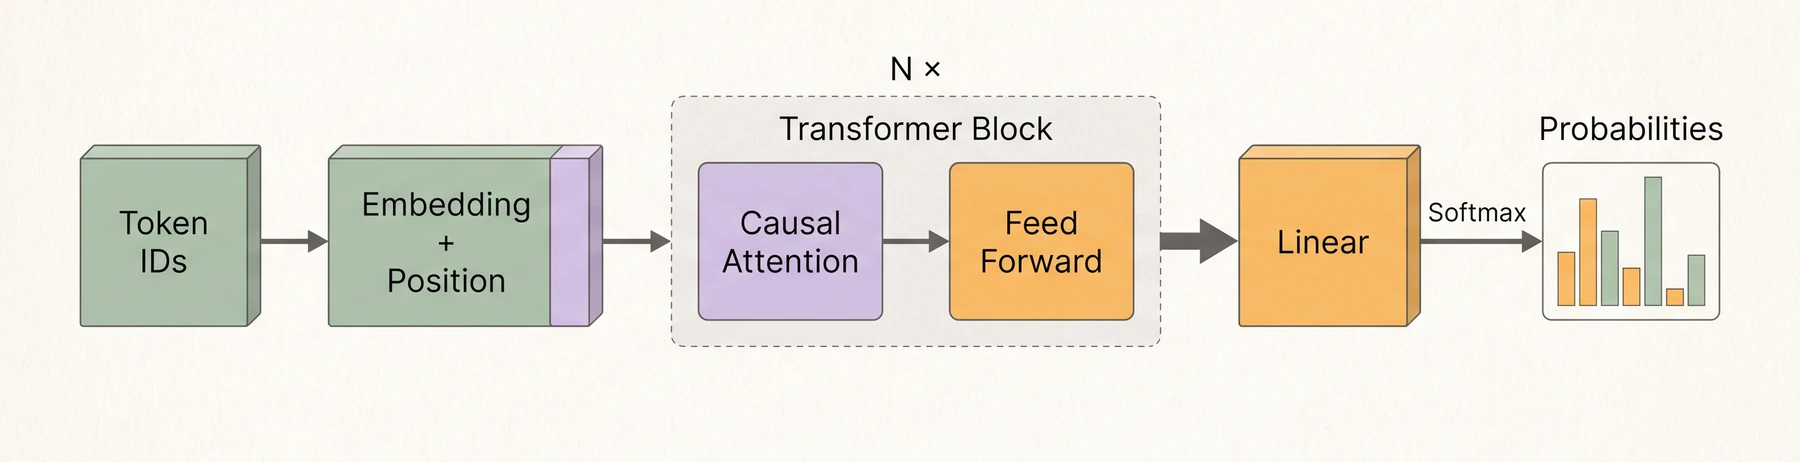
图 1 · Decoder-only 模型的简化数据流。图中省略归一化与残差连接,完整计算顺序见下方代码。原创示意图,AI 辅助绘制。查看大图。
对于一批长度相同的序列,模型的数据流是:
Token IDs (B, T)
  → Token embedding + position embedding (B, T, D)
  → N 个 Pre-LN Transformer Block (B, T, D)
  → 最终 LayerNorm (B, T, D)
  → 词表投影 (B, T, V)
  → 下一个 token 的交叉熵损失
其中 B 是批大小,T 是序列长度,D 是模型宽度,V 是词表大小。如果使用 H 个注意力头,每头的维度就是 d_k = D / H,因此需要满足 D % H == 0。
源码中的相关目录如下。这里列出模块职责,不把目录存在或分词器测试结果当作完整训练正确性的证明。
src/lm_lab/
├── tokenization/        # 文本与 token ID 之间的转换
├── model/
│   ├── attention.py    # 多头因果自注意力
│   ├── layer_norm.py   # 层归一化
│   ├── feedforward.py  # 逐位置前馈网络
│   ├── embedding.py    # 位置编码与位置嵌入
│   └── transformer.py  # Block 与语言模型
├── optimizer/          # SGD、Adam、AdamW 和梯度裁剪
└── training/           # 批次、损失、评估与训练工具
多头因果自注意力
自注意力先把输入投影成查询、键和值,再用查询与键的相似度决定如何汇总值:
因果掩码 M 在允许访问的位置为 0,在未来位置为负无穷。第 i 个位置可以看到 当前位置及此前的位置,即 j <= i,不能看到 j > i。这与训练时的目标右移配合,避免模型直接读取要预测的下一个 token。
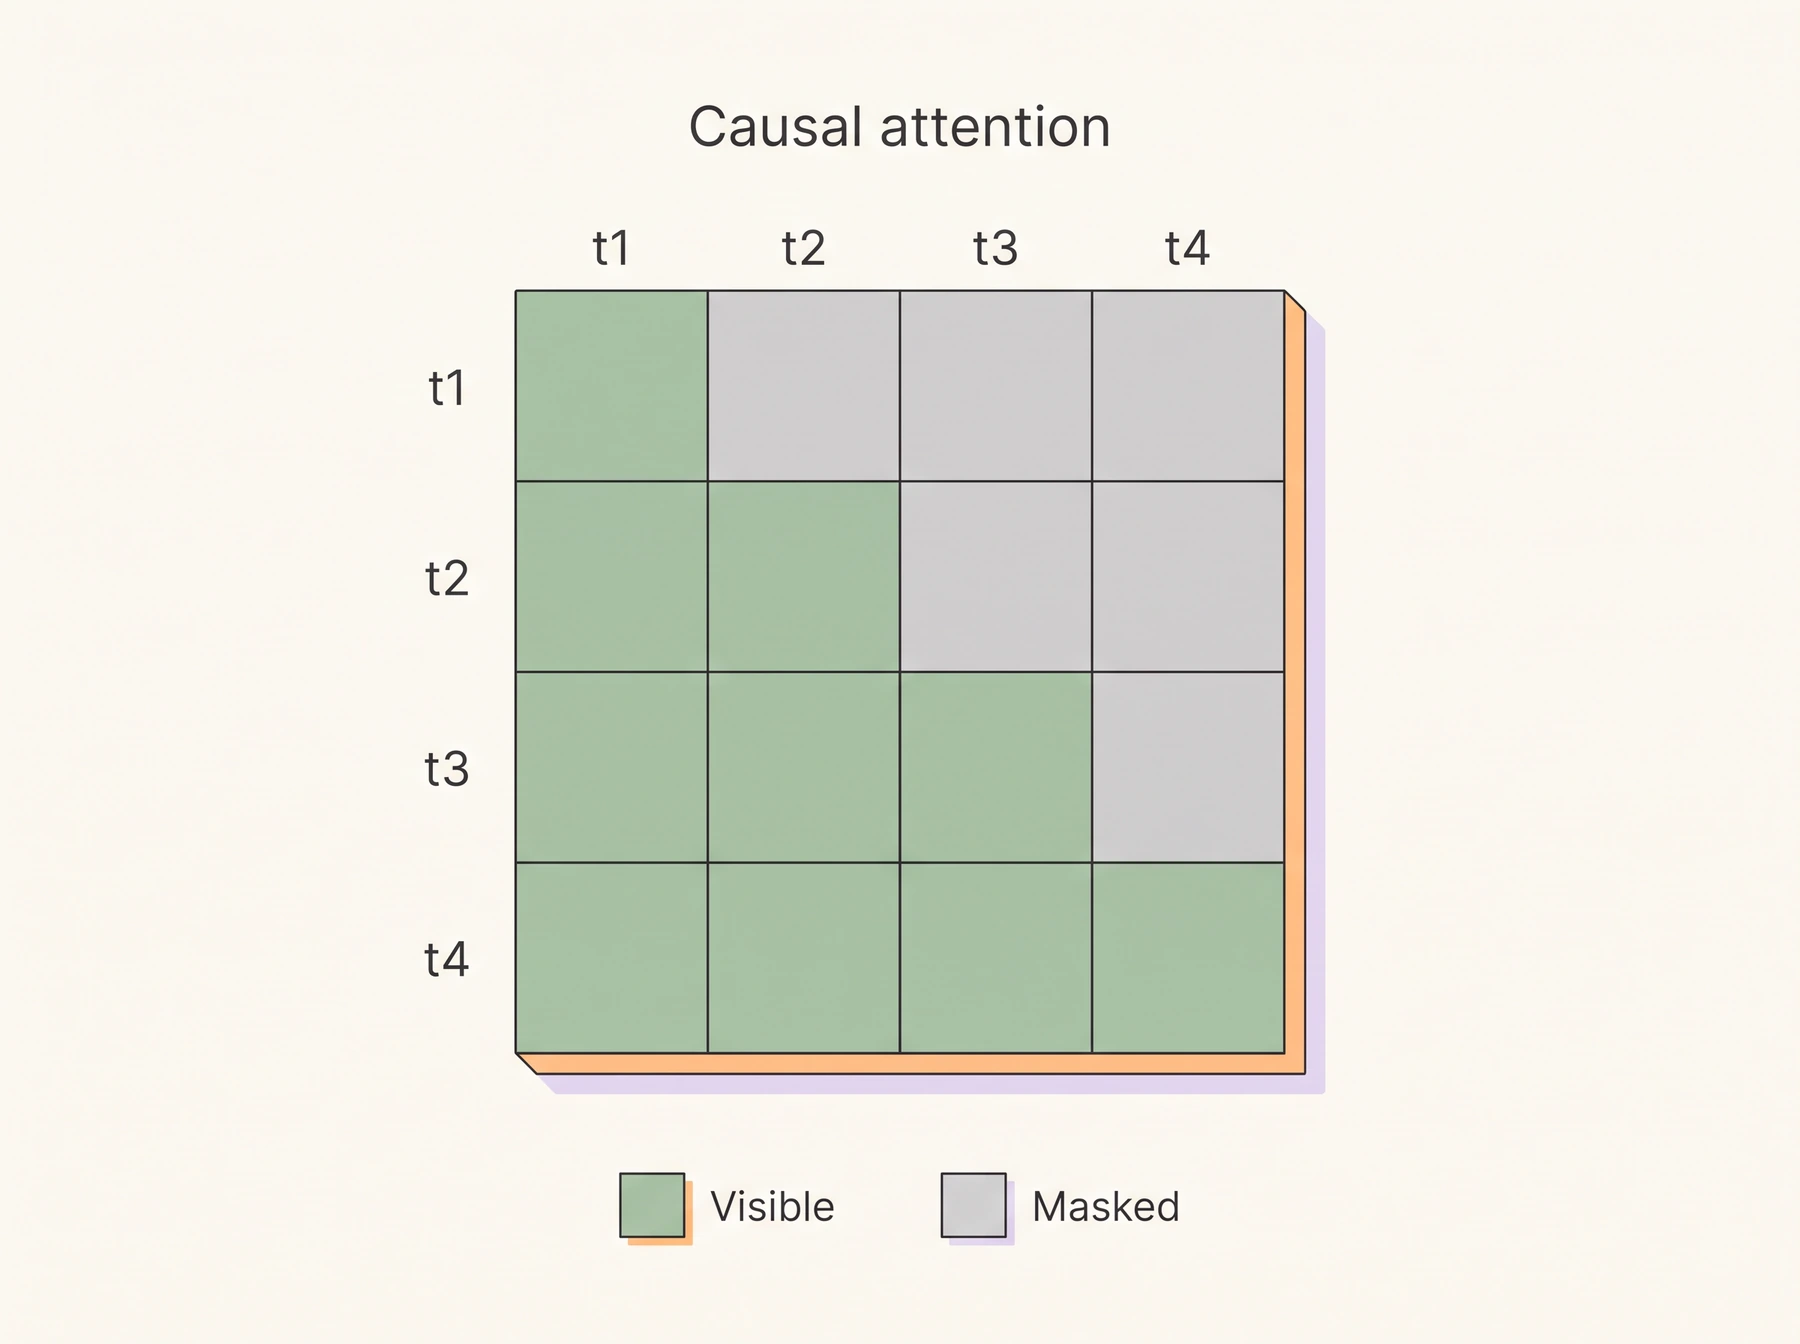
图 2 · 行是查询位置,列是被查询的位置。绿色格子可见,灰色格子被遮住;对角线也参与注意力。原创示意图,AI 辅助绘制。查看大图。
下面保留前向传播的主要步骤,省略构造函数和反向传播缓存:
class CausalSelfAttention:
    def forward(self, x: np.ndarray) -> np.ndarray:
        # x: (B, T, D)
        batch_size, seq_len, d_model = x.shape
        assert d_model == self.d_model
        assert d_model % self.num_heads == 0

        # 1. 一次投影得到 Q、K、V
        qkv = x @ self.qkv_weight + self.qkv_bias
        q, k, v = np.split(qkv, 3, axis=-1)

        # 2. (B, T, D) -> (B, H, T, d_k)
        q = q.reshape(batch_size, seq_len, self.num_heads, self.d_k)
        q = q.transpose(0, 2, 1, 3)
        k = k.reshape(batch_size, seq_len, self.num_heads, self.d_k)
        k = k.transpose(0, 2, 1, 3)
        v = v.reshape(batch_size, seq_len, self.num_heads, self.d_k)
        v = v.transpose(0, 2, 1, 3)

        # 3. 分数矩阵: (B, H, T, T)
        scores = (q @ k.transpose(0, 1, 3, 2)) / np.sqrt(self.d_k)

        # 4. 下三角包含对角线,广播到所有 batch 和 head
        mask = np.tril(np.ones((seq_len, seq_len), dtype=bool))
        scores = np.where(mask, scores, -np.inf)

        # 5. 沿 key 位置归一化
        shifted = scores - np.max(scores, axis=-1, keepdims=True)
        exp_scores = np.exp(shifted)
        attn_weights = exp_scores / exp_scores.sum(axis=-1, keepdims=True)

        # 6. 汇总 V,并把各个头拼回 D 维
        out = attn_weights @ v  # (B, H, T, d_k)
        out = out.transpose(0, 2, 1, 3).reshape(batch_size, seq_len, d_model)

        # 7. 输出投影: (B, T, D)
        return out @ self.out_weight + self.out_bias
缩放 1 / sqrt(d_k) 的作用是控制点积分数的量级。在分量近似独立、方差相近的情况下,点积的方差会随 d_k 增大;分数过大容易让 softmax 变得尖锐,进入梯度很小的区域。缩放改善了这个问题,但不能单独保证梯度或训练稳定。
上面的掩码每一行至少保留对角线,因此 softmax 有有效输入。如果进一步叠加 padding mask,要检查是否出现整行都被遮住的情况;这样的行不能直接套用同一计算。
沿注意力计算图反向传播
手写反向传播时,先拆开计算图,再分别处理矩阵乘法、reshape 和 softmax,比一次写完容易检查。
设 Y = O W_out + b_out,则输出投影的权重梯度是 O.T @ dY。两个矩阵都为方阵时,反过来相乘也可能得到相同的形状,但数值含义已经错了。
下面是无 dropout 情况下的梯度节选。q、k、v、attn_weights、out_pre_proj、mask 和输入形状均来自同一次前向传播的缓存;末尾省略 QKV 投影的参数梯度与输入梯度。
# 1. 输出投影
self.dout_weight = (
    out_pre_proj.reshape(-1, d_model).T
    @ grad_output.reshape(-1, d_model)
)
self.dout_bias = grad_output.sum(axis=(0, 1))
grad_out = grad_output @ self.out_weight.T

# 2. 拼接多头的逆变换
grad_out = grad_out.reshape(
    batch_size, seq_len, self.num_heads, self.d_k
).transpose(0, 2, 1, 3)

# 3. out = attn_weights @ v
grad_attn_weights = grad_out @ v.transpose(0, 1, 3, 2)
grad_v = attn_weights.transpose(0, 1, 3, 2) @ grad_out

# 4. softmax 的向量-雅可比积
grad_scores = attn_weights * (
    grad_attn_weights
    - np.sum(grad_attn_weights * attn_weights, axis=-1, keepdims=True)
)

# 5. 被屏蔽的分数不向 Q、K 传递梯度
grad_scores = np.where(mask, grad_scores, 0.0)
grad_scores /= np.sqrt(self.d_k)

# 6. scores = q @ k.T / sqrt(d_k)
grad_q = grad_scores @ k
grad_k = grad_scores.transpose(0, 1, 3, 2) @ q

# 后续:恢复 QKV 的原始形状,计算投影参数梯度及 grad_x
softmax 的 Jacobian 不需要显式构造。令 a = softmax(s),每一行有:
如果启用 attention dropout,需要缓存 dropout mask,并先把梯度传回 dropout 之前的注意力权重,再计算 softmax 梯度。使用 dropout 之后的权重代入上式会得到错误结果。
LayerNorm、前馈网络与残差连接
LayerNorm:对每个 token 的特征归一化
LayerNorm 在最后一个维度计算均值和方差。对于 (B, T, D) 的输入,每个 token 单独归一化,不跨 batch 或时间位置混合统计量。
class LayerNorm:
    def forward(self, x: np.ndarray) -> np.ndarray:
        mean = x.mean(axis=-1, keepdims=True)
        var = x.var(axis=-1, keepdims=True)
        x_norm = (x - mean) / np.sqrt(var + self.eps)
        return self.gamma * x_norm + self.beta
eps 避免方差很小时除零,gamma 和 beta 是可学习的缩放、平移参数。LayerNorm 有助于控制特征尺度,但合适的初始化、学习率和梯度实现仍然必要。
前馈网络:每个位置共享一组参数
注意力负责位置之间的信息交互,前馈网络负责每个位置上的非线性变换。它不改变序列长度,常见配置把隐藏层扩展到 4 * D 后再投影回来。
class FeedForward:
    def forward(self, x: np.ndarray) -> np.ndarray:
        hidden = x @ self.w1 + self.b1
        hidden = self.gelu(hidden)
        return hidden @ self.w2 + self.b2

    @staticmethod
    def gelu(x: np.ndarray) -> np.ndarray:
        # GELU 的常见 tanh 近似
        return 0.5 * x * (1.0 + np.tanh(
            np.sqrt(2.0 / np.pi) * (x + 0.044715 * x**3)
        ))
GELU 的精确定义是 x * Φ(x),其中 Φ 是标准正态分布的累积分布函数。这里使用平滑的 tanh 近似;反向传播也应使用这份近似的导数,保持前后向一致。
Pre-LN Block:先归一化,再进入子层
class TransformerBlock:
    def forward(self, x: np.ndarray) -> np.ndarray:
        attn_input = self.ln1.forward(x)
        x = x + self.attention.forward(attn_input)

        ffn_input = self.ln2.forward(x)
        x = x + self.ffn.forward(ffn_input)
        return x
也可以写成:
x = x + Attention(LayerNorm(x))
x = x + FFN(LayerNorm(x))
残差连接让输入直接参与输出,因此反向传播时要将直通分支与子层分支的梯度相加。Pre-LN 通常更容易优化,GPT-2 等模型也使用这种顺序;它并不意味着所有配置都可以取消学习率预热。
从 Block 组合成语言模型
token embedding 把 ID 映射成向量,可学习的位置嵌入补充顺序信息。多个 Block 后再做一次 LayerNorm,最后投影到词表。
class TransformerLM:
    def __init__(self, vocab_size, d_model, num_heads,
                 n_layers, d_ff, max_len):
        self.token_embeddings = np.random.randn(vocab_size, d_model) * 0.02
        self.pos_encoding = LearnedPositionalEncoding(d_model, max_len)
        self.blocks = [
            TransformerBlock(d_model, num_heads, d_ff, max_len)
            for _ in range(n_layers)
        ]
        self.ln_f = LayerNorm(d_model)

    def forward(self, input_ids: np.ndarray) -> np.ndarray:
        # input_ids: (B, T)
        x = self.token_embeddings[input_ids]  # (B, T, D)
        x = self.pos_encoding.forward(x)
        for block in self.blocks:
            x = block.forward(x)
        x = self.ln_f.forward(x)

        # 输入嵌入与输出投影共享参数
        return x @ self.token_embeddings.T  # (B, T, V)
输出是 logits,不是已经归一化的概率。权重绑定减少参数量,也意味着同一份 embedding 参数同时接收输入查表和输出投影两条路径的梯度。输入中重复出现的 token ID 要累加梯度,可以用 np.add.at,不能简单覆盖。
可学习的位置嵌入同样需要参数梯度。它的反向接口如果返回 (grad_input, grad_position_embeddings),调用方就必须分别接收;不能把整个元组当作输入梯度继续传递。
Adam 与解耦权重衰减
Adam 维护梯度的一阶矩和二阶矩,并修正它们从零初始化带来的偏差。下面省略状态初始化,假设 self.m[name]、self.v[name] 已是与参数同形状的零数组。
class Adam:
    def step(self, params: dict, grads: dict):
        self.t += 1
        for name, param in params.items():
            grad = grads[name]
            self.m[name] = self.beta1 * self.m[name] + (1 - self.beta1) * grad
            self.v[name] = self.beta2 * self.v[name] + (1 - self.beta2) * grad**2

            m_hat = self.m[name] / (1 - self.beta1 ** self.t)
            v_hat = self.v[name] / (1 - self.beta2 ** self.t)
            param -= self.learning_rate * m_hat / (np.sqrt(v_hat) + self.eps)
一阶矩是梯度的指数移动平均,二阶矩是梯度平方的指数移动平均。t 在一次完整优化步骤中递增一次,不是每更新一个参数就递增。
Adam 本身不要求加入权重衰减。如果把 L2 正则项加到梯度中,它也会进入 Adam 的矩估计;AdamW 则把衰减与自适应梯度更新分开。常见更新形式是:
对应的教学实现如下;这里先衰减旧参数,再做自适应更新,与上式一致。
class AdamW(Adam):
    def step(self, params: dict, grads: dict):
        self.t += 1
        for name, param in params.items():
            grad = grads[name]
            self.m[name] = self.beta1 * self.m[name] + (1 - self.beta1) * grad
            self.v[name] = self.beta2 * self.v[name] + (1 - self.beta2) * grad**2
            m_hat = self.m[name] / (1 - self.beta1 ** self.t)
            v_hat = self.v[name] / (1 - self.beta2 ** self.t)

            param *= 1 - self.learning_rate * self.weight_decay
            param -= self.learning_rate * m_hat / (np.sqrt(v_hat) + self.eps)
实际训练一般还会按参数分组,决定 bias 和归一化参数是否衰减。AdamW 是常用选择,效果仍取决于任务和超参数,不能仅凭优化器名字保证更好的结果。
数值稳定性要放进实现里
Softmax:先减去每一行的最大值
def stable_softmax(x, axis=-1):
    shifted = x - np.max(x, axis=axis, keepdims=True)
    exp_x = np.exp(shifted)
    return exp_x / np.sum(exp_x, axis=axis, keepdims=True)
softmax 对整体平移不变,减去最大值不会改变概率分布,却能避免 exp(1000) 一类的溢出。它假设每个待归一化的行都有有效值,不能修复来自上游的 NaN、正无穷或全部被遮住的输入。
梯度裁剪:按全局范数缩放
def clip_grad_norm(gradients, max_norm=1.0):
    total_norm = np.sqrt(sum(np.sum(g**2) for g in gradients))
    clip_coef = max_norm / (total_norm + 1e-6)
    if clip_coef < 1:
        for g in gradients:
            g *= clip_coef
    return total_norm
这里的 gradients 是可重复遍历的数组列表。范数超过阈值时,所有梯度按同一个系数缩放,保持拼接后的整体方向。裁剪可限制过大的更新,但遇到 NaN 应追查源头,不能依赖裁剪修复。
初始化:区分 fan-in 与 fan-out
# Xavier/Glorot 正态初始化
fan_in, fan_out = d_model, d_ff
W = np.random.randn(fan_in, fan_out) * np.sqrt(2.0 / (fan_in + fan_out))

# He 正态初始化,常用于 ReLU 网络
W_relu = np.random.randn(fan_in, fan_out) * np.sqrt(2.0 / fan_in)
1 / sqrt(d_model) 是一种按 fan-in 缩放的形式;只有输入、输出宽度相等时,它才与上面的 Xavier 标准差一致。初始化应结合激活函数和网络深度选择。
训练流程:先明确标签,再接参数更新
自回归语言模型用当前位置预测下一个 token。对于长度为 T + 1 的 token 序列,输入与标签应相差一个位置:
inputs = tokens[:, :-1]   # (B, T)
targets = tokens[:, 1:]   # (B, T)
如果需要 padding,除注意力掩码外,损失也要忽略 padding 标签,并按有效 token 数归一化。以下交叉熵示例假设所有标签都有效,targets 为整数 ID,使用 log-sum-exp 计算平均损失:
def cross_entropy_with_grad(logits, targets):
    batch_size, seq_len, vocab_size = logits.shape
    flat = logits.reshape(-1, vocab_size)
    labels = targets.reshape(-1)
    rows = np.arange(labels.size)

    shifted = flat - flat.max(axis=-1, keepdims=True)
    exp_logits = np.exp(shifted)
    normalizer = exp_logits.sum(axis=-1, keepdims=True)
    log_probs = shifted - np.log(normalizer)
    loss = -log_probs[rows, labels].mean()

    grad = exp_logits / normalizer
    grad[rows, labels] -= 1
    grad /= labels.size
    return loss, grad.reshape(batch_size, seq_len, vocab_size)
接下来的代码是 训练流程骨架,不是复制后即可运行的仓库脚本。token_batches、collect_named_parameters_and_gradients 和 zero_grad 表示需要实现的批次迭代、参数/梯度收集和清零接口;该版本的模型类尚未提供统一的参数与梯度收集接口。
from lm_lab.model import TransformerLM
from lm_lab.optimizer.adam import AdamW
from lm_lab.utils import set_seed

set_seed(42)

# vocab_size 来自分词器实际生成的词表;不能只用请求的目标大小
model = TransformerLM(
    vocab_size=vocab_size,
    d_model=256,
    num_heads=8,
    n_layers=4,
    d_ff=1024,
    max_len=128,
    dropout=0.0,
)
optimizer = AdamW(learning_rate=3e-4, weight_decay=0.01)

for tokens in token_batches:
    inputs, targets = tokens[:, :-1], tokens[:, 1:]
    zero_grad(model)
    logits = model.forward(inputs, training=True)
    loss, grad_logits = cross_entropy_with_grad(logits, targets)
    model.backward(grad_logits)

    params, grads = collect_named_parameters_and_gradients(model)
    clip_grad_norm(list(grads.values()), max_norm=1.0)
    optimizer.step(params, grads)
    print(f"Loss: {loss:.4f}")
参数与梯度必须使用一致的名字对应起来,包含 attention、FFN、LayerNorm、token embedding 和可学习的位置嵌入。梯度已经在平均交叉熵处除以有效 token 数,子层反向传播不要再额外按 batch 大小平均,否则不同参数的更新尺度会不一致。
调试时,先验证局部正确性
用标量目标做数值梯度检查
中心差分近似的是标量函数对输入的导数。注意力输出是一个张量,不能直接把 attention.forward(x) 当作数值梯度检查的目标。给定上游梯度 g,可以构造 f(x) = sum(attention(x) * g),这样数值梯度与 attention.backward(g) 才是在比较同一件事。
def numerical_gradient(f, x, eps=1e-5):
    grad = np.zeros_like(x)
    it = np.nditer(x, flags=['multi_index'])
    while not it.finished:
        idx = it.multi_index
        old_value = x[idx]
        try:
            x[idx] = old_value + eps
            plus = f(x)
            x[idx] = old_value - eps
            minus = f(x)
            grad[idx] = (plus - minus) / (2 * eps)
        finally:
            x[idx] = old_value
        it.iternext()
    return grad

# 使用小尺寸 float64 输入,并关闭 dropout
x = np.random.randn(1, 3, attention.d_model).astype(np.float64)
g = np.random.randn(*x.shape)
attention.forward(x, training=False)
analytical_grad = attention.backward(g).copy()

numerical_grad = numerical_gradient(
    lambda value: np.sum(attention.forward(value, training=False) * g),
    x,
)
rel_error = np.abs(analytical_grad - numerical_grad) / (
    np.abs(analytical_grad) + np.abs(numerical_grad) + 1e-8
)
print(f"Max relative error: {rel_error.max():.3e}")
误差阈值要结合精度、差分步长和梯度量级判断;接近零的梯度还应检查绝对误差。输入梯度通过后,再分别检查权重和 bias 梯度。数值差分会重复前向传播并覆盖缓存,所以应先保存解析梯度。
检查形状与因果性
先用很小的配置,例如 B=2, T=4, D=8, H=2,逐层断言:
| 张量 | 形状 |
|---|---|
Q / K / V |
(2, 2, 4, 4) |
scores / attn_weights |
(2, 2, 4, 4) |
| 拼接后的注意力输出 | (2, 4, 8) |
| 模型 logits | (2, 4, vocab_size) |
形状正确还不够。关闭 dropout 后,仅修改序列后半段,前半段的输出应保持一致;注意力权重上三角应为零,每个有效行的权重之和应接近 1。这能直接检查因果掩码是否生效。
再尝试过拟合一个小批次
固定一个很小的批次、关闭 dropout,观察 loss 是否明显下降。这是排查数据对齐、梯度收集和参数更新的常用办法。它是待执行的验证步骤,不是本文已经取得的实验结果,也不能替代验证集上的泛化评估。
这个实现适合解决什么问题
NumPy 实现适合观察中间张量、推导梯度和检查计算图。标准 NumPy 通常在 CPU 上运行,注意力还会显式保存 (B, H, T, T) 的矩阵,因此长序列的时间与内存开销增长很快。本文没有性能基准,不能据此给 NumPy、PyTorch 或 TensorFlow 排出训练速度名次。
建议按下面的顺序继续:先验证 LayerNorm 和 FFN,再检查 attention 的前向、反向与因果性;之后统一参数/梯度接口,接通数据批次和交叉熵,最后做小批次学习与验证集评估。GPU、融合算子或分布式训练可以放在数值正确性确认之后。
参考资料与阅读顺序
- Attention Is All You Need:缩放点积注意力与 Transformer。
- GPT-2 技术报告:decoder-only 语言模型与归一化设计。
- Decoupled Weight Decay Regularization:AdamW 与 L2 正则化的区别。
- Stanford CS336:从零实现语言模型的课程材料。
- The Illustrated Transformer:注意力与多头结构的图解。
源码入口是 attention.py 和 transformer.py。克隆项目后,可从分词器测试开始:
git clone https://github.com/liangqianxing/lm-lab
cd lm-lab
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"
pip install numpy
pytest tests/tokenization/ -v
Windows 用户将激活命令替换为 .venv\Scripts\activate。项目早期文档记录的 71 个测试是当时的分词器测试快照,不等于当前测试数,也不证明 Transformer 梯度或端到端训练已经验证。所核对版本的包导出接口仍需兼容性检查,实际结果以所检出的版本和本地测试输出为准。
系列阅读:BPE 分词器 → 本文的模型计算 → LM Lab 项目总结。