多视角推理蒸馏(LLM-MRD)与可审计生成式评审系统(DeepReviewer 2.0)深度拆解
把大语言模型或视觉语言模型(VLM)的深度推理能力用到实际系统中,通常会面临一个两难选择:
- 如果场景受限于毫秒级在线延迟(如高吞吐多模态内容审核与虚假信息检测):直接在线调用 7B~72B 的多模态大模型做长链条思维链(CoT)生成,单次推理往往需要数百毫秒乃至数秒,延迟与算力成本都难以承受;
- 如果场景容许秒级或分钟级深度思考,但对结论的可追溯性要求极高(如科学论文同行评审与技术方案审计):直接让大模型自由生成一段评论,极易出现“遗漏核心实验缺陷”、“拿不同任务/数据集的论文误判新颖性”或“给出空泛不可执行的修改建议”。
本文结合我参与的两项研究工作——LLM-MRD(Multi-View Reasoning Distillation,DASFAA 2026 Oral,arXiv:2603.19293)与 DeepReviewer 2.0(A Traceable Agentic System for Auditable Scientific Peer Review,arXiv:2604.09590),分别拆解这两条互补的技术路线:如何将慢思考多模态教师的知识通过“特征空间残差校准蒸馏”压入 358M 小模型实现 17.2 ms 独立推理,以及如何用“主张-证据-风险台账 + 双重门控”约束复杂推理时 Agent 的输出质量。
第一部分:LLM-MRD —— 为什么不让学生模型直接模仿教师输出 CoT?
在多模态虚假新闻检测(Multimodal Fake News Detection)任务中,给定图文配对样本 ,模型需要判断其真伪 。虚假信息往往隐藏在三个不同维度:
- 文本视角(Text Manipulation):耸人听闻的修辞、逻辑矛盾或事实捏造;
- 图像视角(Image Artifact):拼接篡改痕迹、生成伪影或异常光影;
- 跨模态视角(Text-Image Consistency):真实旧图配虚假新文、图文语义错位。
大参数量的视觉语言模型(如 Qwen2.5-VL)擅长针对上述三个视角做显式推理分析,但参数量达数十亿;而传统的双塔或三路编码器(BERT + MAE + CLIP)推理只需十几个毫秒,却缺乏深层常识与跨视角逻辑推理能力。
1. 显式 Token 级 CoT 蒸馏 vs 隐空间残差校准蒸馏
一种直觉的做法是:让教师模型生成三段 CoT 文本,然后微调一个自回归小模型在测试时先逐 token 生成 CoT 再输出分类标签。但这会带来两个严重问题:
- 在线自回归延迟无法消除:哪怕小模型只有几亿参数,逐 token 生成数百字的分析依然要经历数十步 Decode,完全丧失了判别式编码器单次前向的延迟优势;
- 小模型生成误差累积:小容量模型在长文本生成中极易出现中途幻觉,一旦前面生成的推理链跑偏,建立在推理链之上的最终分类反而比不生成 CoT 更差。
因此,LLM-MRD 采用了**“离线教师多视角推理编码 + 在线学生特征残差校准(Calibration Distillation)”**的设计:教师 Qwen2.5-VL 仅在离线训练阶段使用,其生成的三视角推理链通过冻结的 Sentence Transformer 编码为稠密语义目标向量 ();在线推理阶段完全脱离教师模型,仅运行 358M 参数的学生网络。
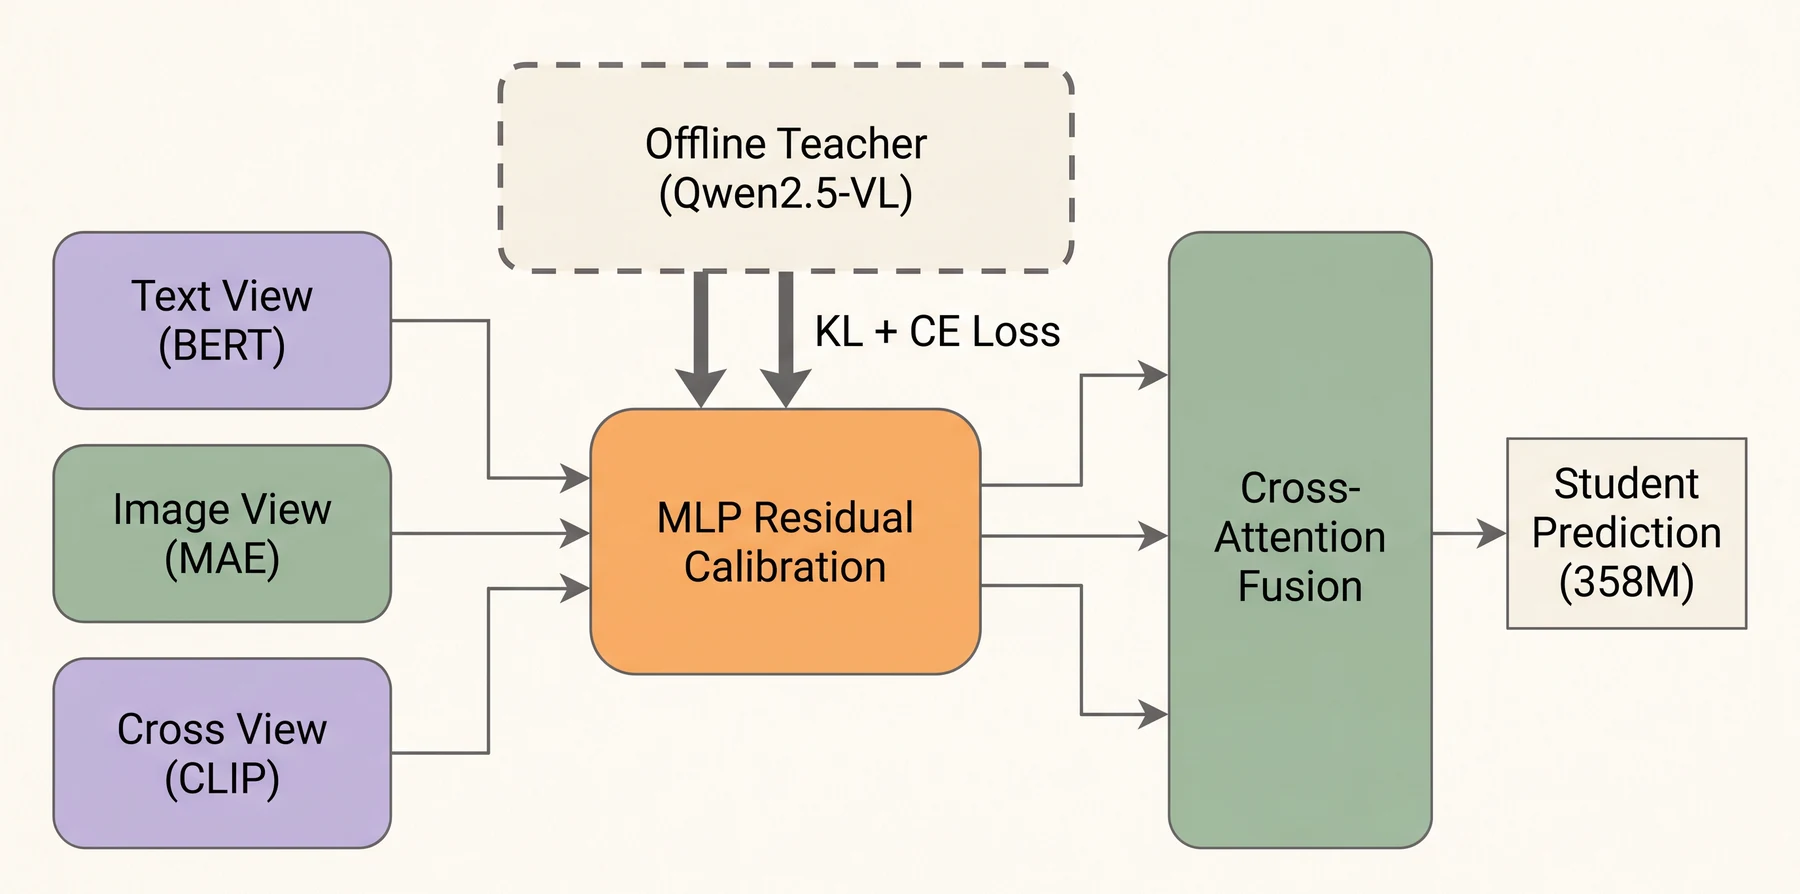
图 1:LLM-MRD 核心架构。学生端提取文本(BERT)、图像(MAE)与跨模态(CLIP)三路特征,通过拼接上下文预测每个视角的残差修正向量,并在温度缩放 KL 与单视角交叉熵联合监督下对齐离线 Qwen2.5-VL 教师表示。查看大图。
2. 多视角残差校准蒸馏的数学形式与实现
设学生网络在三个视角提取的初始特征分别为 。之所以不让每个视角 孤立地通过线性层投影去拟合 ,是因为教师模型在分析单一视角时天然融合了全局图文上下文。为此,LLM-MRD 先将三个视角的特征拼接为全局上下文向量 ,再为每个视角 预测一个残差修正向量(Residual Correction Vector) :
这种残差结构保证了:当教师信号与原始特征一致时,MLP 只需学习接近零的微调;当单一视角特征存在歧义时,可借助另外两个视角的上下文信息将 校准到教师的推理特征流形上。
在监督信号设计上,每个视角 的校准损失 结合了温度缩放 KL 散度与单视角分类交叉熵(Deep Supervision):
其中 为蒸馏温度, 为平衡系数。第二项 的作用非常关键:如果只做特征分布对齐(KL),校准后的特征可能模仿了教师嵌入的几何分布,却丢失了对下游真假二分类边界的判别力;加入单视角 CE 深监督后,强制每个校准后的分支都能独立具备真伪判别能力,避免在后续跨视角融合时出现“弱视角拖累强视角”的模态坍缩。
校准后的三路特征进一步以池化摘要为 Query、未池化的三视角序列特征为 Key/Value 做多视角交叉注意力融合(Multi-View Cross-Attention Fusion),核心 PyTorch 实现如下:
import torch
import torch.nn as nn
import torch.nn.functional as F

class MultiViewCalibrationDistiller(nn.Module):
    def __init__(self, dim: int = 768, num_classes: int = 2, tau: float = 2.0, alpha: float = 0.7):
        super().__init__()
        self.tau = tau
        self.alpha = alpha
        self.views = ("text", "image", "cross")

        # Per-view residual calibration MLPs conditioned on concatenated tri-view context
        self.residual_mlps = nn.ModuleDict({
            v: nn.Sequential(
                nn.Linear(dim * 3, dim),
                nn.GELU(),
                nn.Dropout(0.1),
                nn.Linear(dim, dim),
            )
            for v in self.views
        })
        self.view_classifiers = nn.ModuleDict({
            v: nn.Linear(dim, num_classes) for v in self.views
        })
        self.cross_attn = nn.MultiheadAttention(embed_dim=dim, num_heads=8, batch_first=True)
        self.final_head = nn.Linear(dim, num_classes)

    def forward(
        self,
        student_feats: dict[str, torch.Tensor],          # {v: [B, D]}
        teacher_feats: dict[str, torch.Tensor] | None = None,  # {v: [B, D]}, None at inference
        labels: torch.Tensor | None = None,              # [B]
    ) -> dict[str, torch.Tensor]:
        f_concat = torch.cat([student_feats[v] for v in self.views], dim=-1)  # [B, 3D]

        calibrated = {}
        distill_loss = torch.tensor(0.0, device=f_concat.device)

        for v in self.views:
            d_hat = self.residual_mlps[v](f_concat)
            f_hat = student_feats[v] + d_hat
            calibrated[v] = f_hat

            if teacher_feats is not None and labels is not None:
                p_teacher = F.softmax(teacher_feats[v].detach() / self.tau, dim=-1)
                log_p_student = F.log_softmax(f_hat / self.tau, dim=-1)
                kl = F.kl_div(log_p_student, p_teacher, reduction="batchmean") * (self.tau ** 2)
                ce = F.cross_entropy(self.view_classifiers[v](f_hat), labels)
                distill_loss = distill_loss + self.alpha * kl + (1.0 - self.alpha) * ce

        # Multi-view fusion: pooled calibrated summary queries the 3 calibrated view tokens
        stacked_kv = torch.stack([calibrated[v] for v in self.views], dim=1)  # [B, 3, D]
        query = stacked_kv.mean(dim=1, keepdim=True)                          # [B, 1, D]
        fused, _ = self.cross_attn(query, stacked_kv, stacked_kv)
        logits = self.final_head(fused.squeeze(1))

        out = {"logits": logits}
        if labels is not None:
            main_ce = F.cross_entropy(logits, labels)
            out["loss"] = main_ce + distill_loss / len(self.views)
        return out
3. 三大基准数据集与推理延迟实测对比
在中文(Weibo、Weibo21)与英文(GossipCop)三个公开数据集上,采用 bert-base-chinese / bert-base-uncased、mae-pretrain-vit-base 与 CLIP ViT-B/16 作为学生编码器,离线教师使用 Qwen2.5-VL,实验结果如下:
| 数据集 | 样本规模(Train / Test) | Accuracy | F1-Fake | F1-Real | AUC |
|---|---|---|---|---|---|
7,532 / 1,996 |
0.953 |
0.954 |
0.952 |
0.987 |
|
| Weibo21 | — |
0.959 |
0.957 |
0.968 |
0.988 |
| GossipCop | 10,010 / 2,830(类别不平衡) |
0.902 |
0.719 |
0.946 |
0.885 |
与代表性多模态基线及直接调用 7B LLM 的方案对比,参数量与单样本推理耗时(论文报告口径)如下:
| 方法 | 模型类型 | 在线参数量 | 推理耗时(Reason Latency) |
|---|---|---|---|
| MIMoE-FND | 多模态专家混合 | 397M |
20.5 ms |
| KEN | 知识增强网络 | 382M |
19.7 ms |
| RaCMC | 跨模态多粒度对比 | 424M |
18.8 ms |
| GLPN-LLM | 在线调用大语言模型分支 | 7.07B |
158.0 ms |
| LLM-MRD(本文参与工作) | 离线多视角蒸馏 + 在线残差校准学生 | 358M |
17.2 ms |
结果解读与局限性边界:
- 提升口径辨析:论文摘要中提到的
ACC +5.19%是相对于全部 12 个基线方法在三个数据集上的平均相对提升;若严格对比每个数据集上最强的单一基线(主表Improv.行),Weibo、Weibo21 与 GossipCop 上的准确率提升分别为1.93%、0.31%和0.67%。在技术交流中明确区分“对全基线均值”与“对最强基线 Margin”,能避免夸大陈述。 - 离线教师幻觉与可解释性边界:虽然学生模型学到了对齐教师推理空间的稠密表示,但在线部署时它只输出分类概率与注意力权重,不再生成自然语言 CoT;此外,公开方法尚未在离线阶段对
Qwen2.5-VL生成的推理链施加外部事实核查过滤,若教师在生僻事件上产生幻觉,噪声仍可能通过 KL 项传给学生,这也是后续引入标签条件一致性过滤(Label-Conditioned Consistency Filtering)的改进方向。
第二部分:DeepReviewer 2.0 —— 用台账与双门控构建可审计的评审 Agent
如果说 LLM-MRD 解决的是“把慢思考压缩成快直觉”,那么在科学同行评审(Scientific Peer Review)这类高严肃性任务中,我们需要的恰恰相反:不能只给一个黑盒分数,而必须让每一条批评都能追溯到原论文的具体页码与行号,让每一次新颖性否定都有同设定文献支撑。
在 前一篇关于 CycleResearcher 的后训练笔记 中,我们已经区分过“通过 SFT + SimPO 更新模型权重”与“推理时认知编排”。在 DeepReviewer 2.0(arXiv:2604.09590)中,我们聚焦于:哪怕不针对审稿任务微调底层大模型(主系统运行于 Step-3.5-Flash),如何通过严格的数据结构契约与两阶段门控,把自由文本生成改造为可审计的工程流水线?
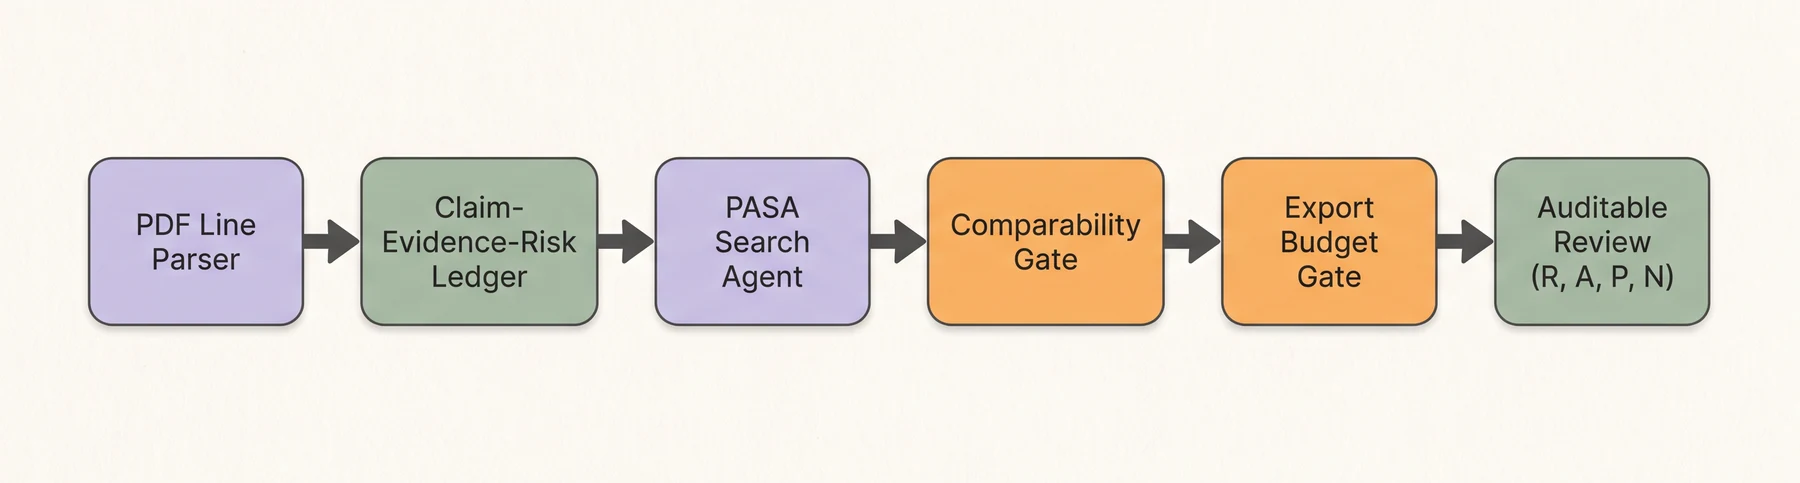
图 2:DeepReviewer 2.0 的两阶段审计流水线。Stage I 仅基于原论文构建主张-证据-风险台账(Claim-Evidence-Risk Ledger);Stage II 按验证议程调用 PASA 检索,并依次通过可比性门控(Comparability Gate)与导出预算门控(Export Budget Gate)。查看大图。
1. 形式化输出契约 与行号级证据锚定
DeepReviewer 2.0 拒绝输出笼统的散文式审稿意见,而是强制要求最终评审包满足四元结构契约:
- (Structured Review):结构化总评,包含核心贡献摘要、优势、缺陷与总体裁定;
- (Anchored Annotations):与原论文具体位置强绑定的批注集合 。每条批注必须包含页码与行号区间(
page + line_span)、问题类别、严重程度、科学风险说明以及可执行修复动作(选用page + line_span而非纯 PDF 像素框bbox作为主锚点,是为了防止不同 PDF 渲染器微小排版偏移破坏定位稳定性); - (Prioritized Revision Plan):按风险严重度排序的作者修改路线图;
- (Novelty & Value Assessment):基于外部检索证据的新颖性评估,当检索证据不足以覆盖时显式保留
unclear状态,严禁无根据臆断。
2. Stage I(内生台账)与 Stage II(PASA 可比性门控 + 导出门控)
整条流水线分为严格隔离的两个阶段:
- Stage I:零外部检索的
Claim-Evidence-Risk Ledger(主张-证据-风险台账) 系统首先将论文 PDF 解析为带页码和行号的语义块并逐页重读(缓解长上下文 Lost-in-the-Middle),在不接触任何外部文献的前提下,提取作者的核心主张(Claim)、文内实验或定理证据(In-paper Evidence)以及潜在方法/实验漏洞(Risk),标记为confirmed或suspected。高风险且需外部佐证的条目自动生成检索验证议程(Verification Agenda)。 - Stage II:PASA 检索与
Matched-Setting Comparability Gate(同设定可比性门控) 大模型审稿最常见的错误之一,是搜到一篇标题相似的论文就直接指责作者“缺乏新颖性(Lack of Novelty)或漏引 SOTA”,哪怕两篇论文解决的子任务、数据集或评价指标根本不同。为此,我们在 PASA 学术检索 Agent 之后设立了同设定可比性门控:只有当检索到的候选文献 与被审稿件 在**任务定义(Task)、基准数据集(Dataset/Benchmark)与主评价指标(Primary Metric)**三项上同时匹配时,才允许将其作为直接竞争基线用于新颖性重叠判定(划分为supported、partially overlapping、substantially overlapped或unclear):
Export Budget Gate(导出预算硬门控) 在最终生成评审包 之前,导出校验器会执行确定性检查:必须完成至少 3 次独立文献检索、覆盖至少 3 类不同验证意图、生成至少 10 条具备合法page + line_span锚点及可执行修复建议的批注,且 JSON Schema 校验完全通过,否则打回补充验证。
3. 134 篇 ICLR 投稿盲评实验与真实能力边界剖析
在 134 篇 ICLR 2025 真实投稿上,我们采用三套协议评估系统表现:Protocol 1(相对人类评审关注点的严格问题覆盖率 Strict Issue Coverage)、Protocol 2(多自动评审系统池内匿名盲排,1000 次 Paper-level Bootstrap 计算 95% 置信区间)以及 Protocol 3(与人类评审委员会档案的匿名成对盲比):
| 评测维度 / 指标 | DeepReviewer 2.0 | 对照基线表现 |
|---|---|---|
| Strict Overall Issue Coverage(全样本严格覆盖率) | 35.74% |
CycleReviewer-123B:23.92% |
| Major Issue Coverage(核心重大问题覆盖率) | 37.26% |
Gemini-3.1-Pro Baseline:23.57% |
| 自动系统池 Bradley-Terry Elo | 2057.17 |
95% CI:[1990.55, 2140.81],池内平均胜率 92.34% |
| 对人类评审委员会总胜率(Win / Tie / Loss) | 71.63% / 16.28% / 12.09% |
固定 Rubric 与评委模型条件下 |
如果只看 71.63% 的总体偏好胜率,很容易产生“AI 审稿已经超越人类专家”的错觉。但拆开对人类委员会的五个细分维度胜率与漏检率,就能看清当前系统的真实工程边界:
| 细分评测维度 | 对人类评审委员会胜率 | 现象与工程边界诊断 |
|---|---|---|
| Communication Clarity(表达清晰度) | 86.05% |
结构化台账与行号锚定让报告条理极佳 |
| Constructive Value(建设性价值) | 84.50% |
Export Gate 强制每条批评附带可执行修复建议 |
| Overall Judgment(总体裁定合理性) | 69.77% |
受益于证据汇总的全面性 |
| Technical Accuracy(技术准确性) | 59.69% |
优势显著收窄,深层数学推导与隐蔽实验缺陷仍难捕捉 |
| Analytical Depth(分析深度) | 58.14% |
接近五五开,且 Major Issue 漏检率仍达 62.74% |
这组细分数据清楚地表明:DeepReviewer 2.0 的高胜率主要来自“结构化可追溯性、表达清晰度与可执行修复建议(84%~86%)”,而在核心技术准确性与分析深度(58%~59%)上与人类专家差距很小,且对人类指出的核心大问题仍有 62.74% 的未覆盖率(Critical Miss Rate),在伦理审查(Ethics)维度严格覆盖率更是为 0%。 此外,成对排名依赖同一模型家族的 Judge,也存在对结构化长文风格的潜在偏好。因此,这类系统的准确定位应当是帮助作者在投稿前做结构化自检与文献漏引排查的审计助手,而非替代人类同行评审的最终裁决者。
三、小结:模型压缩与系统门控的协同
把 LLM-MRD 与 DeepReviewer 2.0 放在一起看,可以提炼出大模型工程落地的两条通用准则:
- 当在线延迟预算是硬约束(如
< 20 ms)时,把多视角推理留在离线训练侧:用强大的多模态教师离线生成结构化推理信号,通过残差校准与温度缩放 KL + 分支 CE 深监督把“推理结果对应的特征几何”压进轻量级编码器,避免在线自回归生成。 - 当任务允许充裕推理时间但要求高可靠性时,用确定性数据结构与门控夹住生成过程:不依赖单次 Prompt 祈祷模型不犯错,而是把状态显式化为可检验的台账(Ledger),在检索端加同设定可比性门控,在输出端加预算与锚点完整性门控。
本文封面与两张架构流水线图使用 aigc-image-generator 辅助生成并经人工核对,实验数值与边界分析均与公开论文及复核记录严格一致。