多约束生产级 Agent 系统实践:两阶段工具路由、DAG 局部重规划与轨迹级评测闭环
在玩具级 Demo 里,几个工具加上一段 ReAct 循环就能跑通大多数单步问答。但当 Agent 进入跨境酒旅、复杂交易或研发沙箱等真实业务生产环境时,单靠线性 ReAct 循环很快会撞上四堵墙:
- 工具空间与参数耦合爆炸:候选 API 数量动辄上百,工具之间存在严格的先后依赖(如“外币汇率锁定”必须在“跨时区房态核验”之后),把全量工具 Schema 塞进 Prompt 不仅消耗巨量 Token,还会导致模型出现工具名混淆与参数漏传;
- 跨语言实体与计费/时区口径歧义:用户输入可能是中文俗称或拼写变体(如“京都河原町附近可免费取消的双床房”),而底层库存接口要求标准化的多语言 GeoEntity ID、精确到目的地本地时区的退改截止时间戳以及含税/不含税计费枚举;
- 下游实时异常引发的全链路作废:多步规划执行到第 4 步时,某个房型突然返回库存售罄(
INVENTORY_EXHAUSTED)或价格异动。若直接回退重跑整个任务图,不仅浪费前序已完成的只读查询,还会使端到端延迟翻倍; - Observation 冗余撑爆上下文窗口:单次房态或政策查询返回的原始 JSON 往往夹杂大量多语言营销文案、历史费率明细和冗余 HTML 标签,几轮交互后核心约束反而被挤出注意力焦点。
本文结合我在多约束业务 Agent 架构中的工程实践,以及本机完成的 30 项 Agent 工具调用故障模式基线实验与多随机种子 SFT/DPO 对齐实验,系统梳理从两阶段工具路由、DAG 局部子图重规划、上下文裁剪到轨迹级 Rubrics 评测与偏好对齐的完整闭环。
一、先看基线数据:Agent 在哪类任务上最容易失败?
在动手堆叠复杂架构之前,我先在本地构造了一套包含 30 个任务的受控评测集(experiments/agent-eval/run_eval.py),将任务均分为三类:A. 基础文件与信息提取(File Ops,10 项)、B. 多步依赖规划(Multi-Step Planning,10 项)、C. 异常注入与错误恢复(Error Recovery,10 项)。每个任务预设期望调用步数与合法工具集,自动统计完成率、调用步数与故障分类(hallucinated_tool、wrong_args、no_error_recovery、excessive_calls、parse_error)。
实测汇总结果(来自 experiments/agent-eval/results.json)如下:
| 任务类别 | 完成任务数 / 总数 | 类别成功率 | 已完成任务平均工具调用次数 | 主要失败模式 |
|---|---|---|---|---|
| Category A:单步/浅层操作(File Ops) | 9 / 10 |
90.0% |
1.33 |
1 例长耗时命令输出截断导致未完成 |
| Category B:多步依赖规划(Multi-Step Planning) | 7 / 10 |
70.0% |
2.14 |
3 例在中途步骤失败后缺少局部重规划(no_error_recovery) |
| Category C:显式单点错误恢复(Error Recovery) | 10 / 10 |
100.0% |
1.80 |
0 例失败(单点明确报错时模型能自我修正) |
| 全量汇总(Total,30 Tasks) | 26 / 30 |
86.7% |
1.73 |
no_error_recovery: 3, parse_error: 1, hallucinated_tool: 0.0% |
这组基线揭示了一个非常典型的现象:当任务只有一个明确的报错点(Category C,如“命令拼写错误 pyhon3 后修正重试”或“权限拒绝后优雅降级”)时,现代指令微调模型的恢复率可以达到 100.0%;真正的短板集中在多步依赖规划(Category B,成功率降至 70.0%)——一旦链路拉长、前序步骤的输出格式偏离预期或中间节点状态失效,自由演进的 ReAct 循环很容易丢失全局约束或卡在死胡同里。
这正是引入两阶段受控工具路由与显式 DAG 局部子图重规划的核心动因。
二、两阶段工具路由与跨语言实体/Schema 强校验门控
面对上百个业务 API,直接把所有 JSON Schema 暴露给 Planner 既昂贵又脆弱。我们将工具调用拆成“粗召回 精排生成 确定性门控校验”三级流水线:
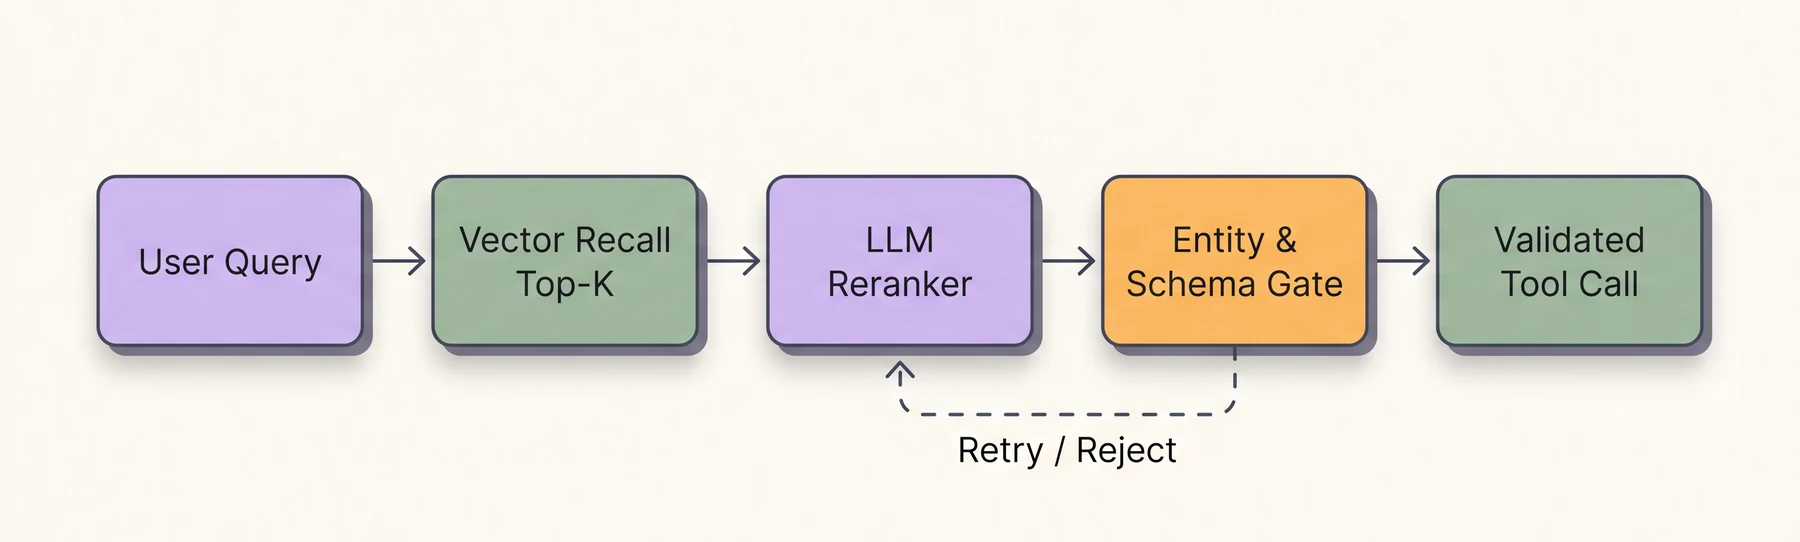
图 1:两阶段工具路由与校验门控(Entity & Schema Gate)。未通过实体链接或 JSON Schema 校验的调用不会打向下游微服务,而是附带结构化诊断信息触发局部重试。查看大图。
1. 向量 Top-K 召回与业务域过滤
令工具库为 。每个工具 的索引文档不仅包含函数签名与自然语言描述,还拼接了适用业务域标签(如 domain: hotel_inventory、requires: geo_entity_id)及正反例 Query。给定当前子任务描述 与已解析槽位集合 ,第一阶段通过稠密向量内积结合硬置条件过滤召回候选集 :
其中 是前置槽位就绪检查——例如在尚未拿到标准化 hotel_id 时,强制要求 hotel_id 的下游锁单接口不会进入当前步的精排候选池,从源头上消灭“依赖倒置调用”。
2. 跨语言实体链接与 Schema/业务规则双层门控
第二阶段由 LLM 在 个候选工具中精排并生成参数载荷 。但 LLM 输出的 JSON 绝不直接发往生产接口,而是先经过确定性的 Entity & Schema Gate:
from dataclasses import dataclass
from datetime import datetime
from zoneinfo import ZoneInfo
from typing import Any

@dataclass
class GateVerdict:
    passed: bool
    normalized_args: dict[str, Any]
    error_code: str | None = None
    repair_hint: str | None = None

class ToolCallGate:
    def __init__(self, entity_linker, schema_registry):
        self.entity_linker = entity_linker
        self.schemas = schema_registry

    def validate_and_normalize(self, tool_name: str, raw_args: dict[str, Any]) -> GateVerdict:
        schema = self.schemas.get(tool_name)
        if not schema:
            return GateVerdict(False, {}, "UNKNOWN_TOOL", f"Tool '{tool_name}' is not in candidate set.")

        # 1. Required fields & JSON Schema type check
        missing = [k for k in schema["required"] if k not in raw_args or raw_args[k] in (None, "")]
        if missing:
            return GateVerdict(False, raw_args, "MISSING_REQUIRED_PARAM",
                               f"Missing required fields: {', '.join(missing)}")

        args = dict(raw_args)

        # 2. Cross-lingual entity linking (e.g., '河原町' / 'Kawaramachi' -> canonical geo_id)
        if "destination_query" in args and "geo_entity_id" not in args:
            match = self.entity_linker.resolve(args["destination_query"], lang_hint=args.get("locale"))
            if not match or match.confidence < 0.85:
                return GateVerdict(False, args, "AMBIGUOUS_ENTITY",
                                   f"Cannot uniquely link '{args['destination_query']}'; candidates: {match.top3 if match else []}")
            args["geo_entity_id"] = match.entity_id
            args[" target_tz"] = match.timezone

        # 3. Cross-timezone & billing semantics guard
        if "check_in_date" in args and "check_out_date" in args:
            tz = ZoneInfo(args.get("target_tz", "UTC"))
            ci = datetime.strptime(args["check_in_date"], "%Y-%m-%d").replace(tzinfo=tz)
            co = datetime.strptime(args["check_out_date"], "%Y-%m-%d").replace(tzinfo=tz)
            if co <= ci:
                return GateVerdict(False, args, "INVALID_DATE_RANGE",
                                   "check_out_date must be strictly after check_in_date in destination local time.")

        return GateVerdict(True, args)
在实际工程链路中,这套包含跨语言实体链接 + JSON Schema 校验 + 跨时区/计费枚举检查的前置门控,将发往下游接口的实际调用合法率稳定提升至 96% 以上,并且把绝大多数参数错误拦截在毫秒级的进程内校验阶段。
三、基于状态机的 DAG 调度与局部子图重规划
对于包含多约束查询、比价、政策核验与组合预订的复杂请求,我们将任务分解建模为有向无环图 。每个节点 维护显式状态机:
当全部前驱节点 均处于 时,节点 转入 并可由调度器并发执行。
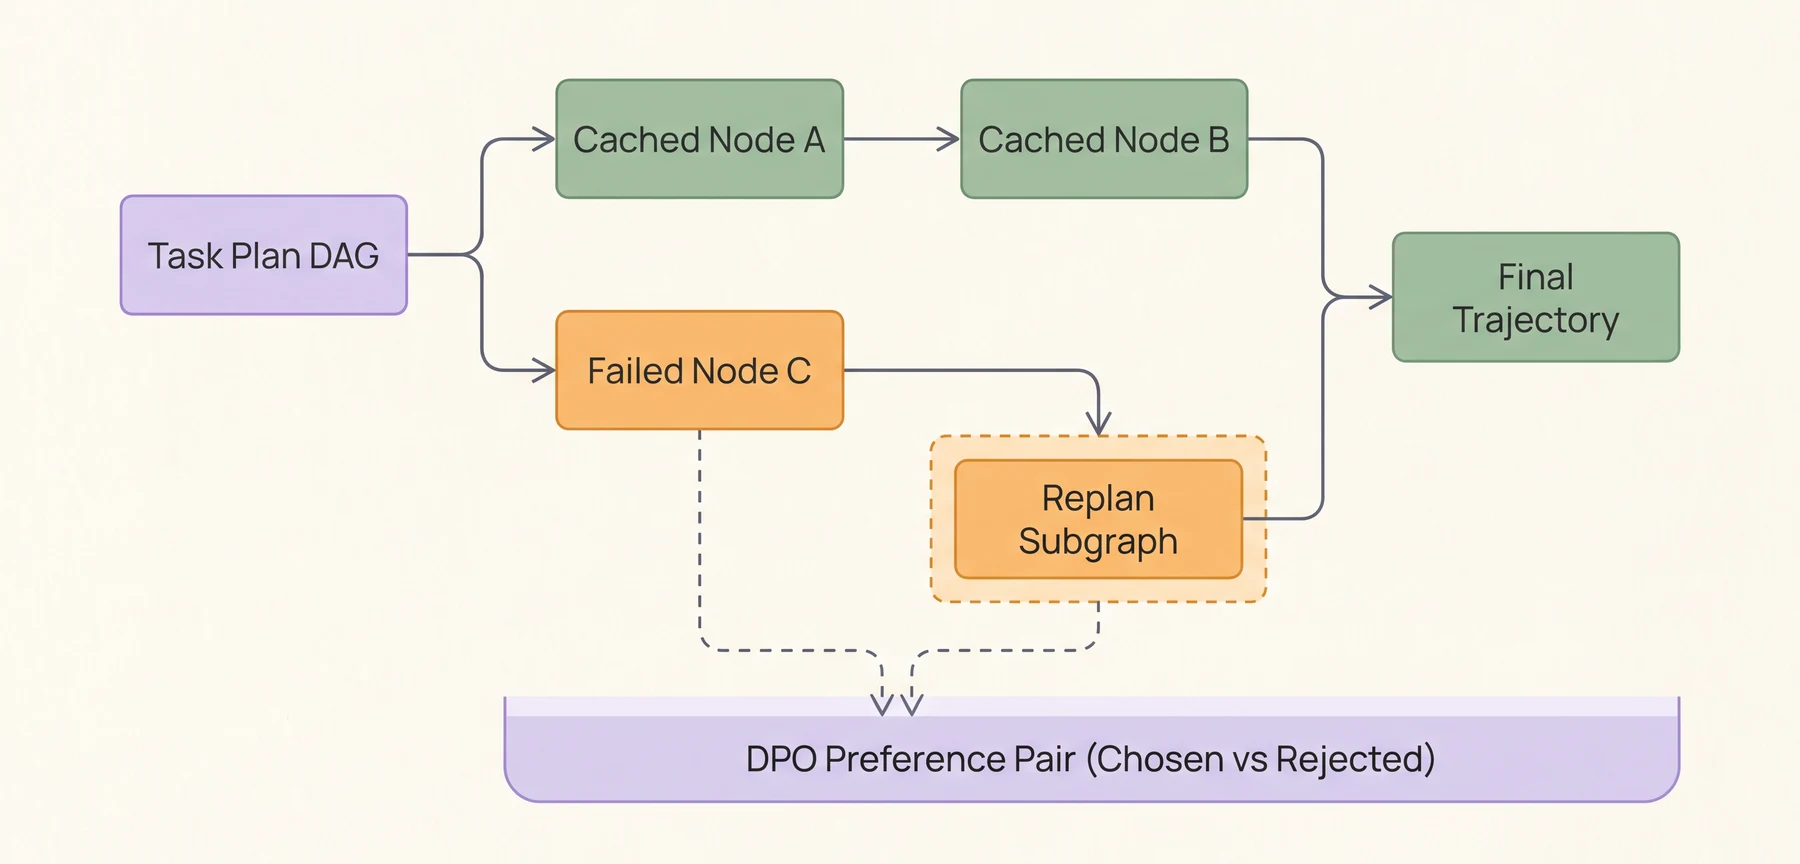
图 2:DAG 局部子图重规划(Local Subgraph Replanning)。当节点 C 失败时,上方已完成的只读分支 Node A Node B 保持缓存复用,仅对受影响子图做局部替换,并将失败与修正轨迹配对沉淀为 DPO 训练样本。查看大图。
局部子图重规划(Local Subgraph Replanning)算法
假设节点 在执行时返回可恢复的业务异常(例如首选酒店房型售罄、或实时税后总价超出用户预算上限)。全局重规划会丢弃整张图 ;而局部子图重规划仅失效 及其在图中的可达后继闭包 ,完全保留与之正交的已完成节点集合 :
调度器将 的输出摘要、 的具体失败原因(error_code 与实时约束反馈)交给 Replanner,生成替代子图 并热挂载回原 DAG:
from collections import deque

def invalidate_and_replan(dag, failed_node_id: str, failure_obs: dict, replanner) -> None:
    # 1. BFS to find downstream dependency closure Desc(v_fail)
    to_invalidate = set()
    queue = deque([failed_node_id])
    while queue:
        curr = queue.popleft()
        if curr in to_invalidate:
            continue
        to_invalidate.add(curr)
        for nxt in dag.successors(curr):
            queue.append(nxt)

    for nid in to_invalidate:
        dag.nodes[nid].state = "INVALIDATED" if nid != failed_node_id else "FAILED"

    # 2. Collect preserved outputs from completed independent branches
    preserved_context = {
        nid: node.output_summary
        for nid, node in dag.nodes.items()
        if node.state == "COMPLETED" and nid not in to_invalidate
    }

    # 3. Synthesize replacement subgraph for the invalidated region only
    new_subgraph = replanner.propose_subgraph(
        original_goal=dag.goal,
        preserved_outputs=preserved_context,
        failed_node=dag.nodes[failed_node_id].spec,
        failure_observation=failure_obs,
    )
    dag.splice_subgraph(replace_nodes=to_invalidate, subgraph=new_subgraph)
这样一来,像“目的地地理编码解析”、“汇率与退改基准查询”或“另一家备选酒店的房态核验”等已完成分支无需重复请求,既保护了下游接口配额,又显著降低了异常恢复的尾延迟。
四、Observation 冗余裁剪与按目的地动态 Few-Shot 注入
在长链路工具调用中,工具返回的原始 JSON(Observation)往往占据了上下文 Token 的 以上。针对跨境酒旅场景,我们实施了两项正交的上下文工程策略:
- Schema 感知的 Observation 裁剪器(节省约 40% 上下文 Token):
不同阶段的子任务对工具返回值的字段需求是高度稀疏的。我们为每类工具定义了“决策必需投影视图(Decision Projection Schema)”——在工具返回原始大 JSON 后,先剥离未命中当前语言环境的冗余多语言长描述、静态酒店设施长列表、历史价格快照以及冗余 HTML 样式标签,仅保留与当前约束核验直接相关的结构化字段(如
room_type_id、total_price_tax_inclusive、free_cancel_deadline_utc、remaining_ allotment),并将原始完整载荷存入外部键值沙箱按引用 ID(obs_ref_id)备查。实测这一步可稳定削减约 40% 的上下文 Token 消耗。 - 按目的地动态注入 Few-Shot 规则:
不同国家/地区在酒旅计费口径上差异极大(例如日本住宿税按人头阶梯征收、欧美度假村费 Resort Fee 是否计入预付总额、跨夏令时退改截止时间换算)。如果把全球所有地区的计费特例都写进固定 System Prompt,既浪费 Token 又容易互相干扰。通过根据第一步实体链接解析出的目的地国家/地区代码(如
JP-KYOTO、US-NV),动态从规则库检索对应的 1~2 条精简 Few-Shot 算例注入当前上下文,有效消除了计费口径歧义与跨时区退改换算错误。
五、Rubrics 轨迹评测与失败→重规划偏好对齐(SFT / DPO)
线上或沙箱沉淀的多步交互轨迹(Trajectory),不仅是监控指标的来源,更是后训练(Post-training)最宝贵的数据矿藏。
1. 过程与结果双层 Rubrics 自动归因
针对多步轨迹 ,我们围绕四类高频 Bad Case 构建了自动化过程检查点(Process Checkpoints)与结果验收规则(Outcome Rubrics):
- 实体混淆(Entity Confusion):下游调用传入的
hotel_id/geo_id是否与前序实体链接高置信度结果一致; - 参数漏传与类型漂移(Missing / Malformed Args):是否被
ToolCallGate拦截; - 时区与计费误判(Timezone & Billing Mismatch):最终回复中的免费取消截止时间是否已正确转换为用户或目的地约定标注时区,总价是否明确区分含税与到店另付税费;
- 依赖倒置(Dependency Inversion):是否存在未经实时核验就直接输出确定性库存/价格承诺的行为。
2. 从“拦截/重规划”轨迹构造 Chosen / Rejected 偏好对
当同一个任务上下文 在线上或沙箱中经历了**“初次规划/调用触发门控拦截或下游异常() 经诊断反馈与局部重规划后成功完成验收()”**时, 天然构成了一对共享完全相同前置上下文、且优劣边界由确定性规则验证过的偏好样本!
为了验证 SFT 与 DPO 串联链路在不同随机种子下的真实收益与方差特性,我在本地使用 Qwen2.5-0.5B 模型(rank = 8, alpha = 16, lr = 2e-4 for SFT;beta = 0.1, lr = 5e-5 for DPO)在固定数据划分(80 train / 20 val)和三个独立随机种子(seeds = 42, 123, 456)下运行了完整对照实验(原始记录保存于 experiments/lora-sft/、experiments/dpo/ 与 experiments/sft-dpo-pipeline/):
| 训练阶段与配置(3 Seeds 均值 标准差) | Val Loss | 偏好准确率 Reward Accuracy | 相对 Base 模型的 NLL 改善 |
|---|---|---|---|
| Base 模型(未微调基线) | 3.5973 ± 0.0000 |
— | 基线对照 |
| 单独 LoRA SFT(3 Epochs) | 2.6177 ± 0.0056 |
— | 验证集 Loss 稳定下降 27.2%,种子间方差极小 |
| 单独 DPO(直接在 Base 上训练) | 0.6699 ± 0.0033 |
60.0% ± 0.0% |
偏好 Margin 为正(+0.0566),但基座未适应领域格式 |
| SFT DPO 串联流水线(2 Epochs DPO) | 0.6290 ± 0.0061 |
81.7% ± 2.4% |
Reward Margin 提升至 +0.2194 ± 0.0156 |
实验数据非常清晰地展示了两点工程事实:
- 先做领域 SFT 再做 DPO 的必要性:直接在未经过领域格式微调的 Base 模型上跑 DPO,验证集偏好准确率停留在
60.0%,隐式奖励裕度()仅为+0.0566;而在 SFT checkpoint 之上继续进行 DPO,验证集偏好准确率跃升至81.7% ± 2.4%(单种子最高85.0%),奖励裕度扩大了近 4 倍(+0.2194)。 - DPO 训练中的生成 NLL 漂移监控:在本地
sft-dpo-pipeline/results.json的交叉监控中,我们也观察到纯 DPO 损失虽然拉大了 Chosen 与 Rejected 的相对 Margin,但单看 Chosen 序列的绝对交叉熵(SFT Val Loss)会从 SFT 阶段末期的2.5734轻微回升至2.7524。这印证了在生产级后训练中,需要在 DPO 目标中加入小权重的 SFT 负对数似然正则项(即 ),以防止模型为了拉大偏好差距而牺牲结构化输出语法的稳定性。
实验与工程边界说明
- 文中关于跨境酒旅多约束路由、96%+ 接口调用合法率与约 40% Observation Token 节省,对应业务研发平台实习期间的工程架构实践总结;代码片段为剥离内部业务逻辑后的通用机制重构。
- 第五节的 30 项 Agent 故障归因基线与 Qwen2.5-0.5B 三种子 SFT/DPO 数值,来自本地独立复现实验(80/20 样本划分),用于定量验证“多步规划恢复短板”与“SFT DPO 串联增益及 NLL 漂移现象”,不直接等同于千亿参数生产模型在全量业务流量上的线上指标。
本文封面与两张机制图使用 aigc-image-generator 辅助绘制并经人工核验。